Веб-скрапинг или API: как извлекать данные JSON с помощью Python


Если сайт уже загружает данные через JSON-эндпоинт, обращение к нему обычно быстрее, чем скрапинг HTML или запуск Selenium. Вы получаете структурированные данные прямо из источника, который использует сама страница, и не ждёте, пока браузер отрисует каждую кнопку, карточку, скрипт, изображение и всплывающее окно.
Скрапинг HTML и браузерный скрапинг по-прежнему нужны. Некоторые сайты помещают данные прямо в исходный код страницы. Другим требуются клики, прокрутка, формы или отрисовка в браузере. Но на многих динамических сайтах самый чистый путь начинается во вкладке Network в браузере.
Современный веб даёт скраперам повод проверять этот путь в первую очередь. Глава о JavaScript в HTTP Archive Web Almanac сообщает, что в 2024 году медианный объём JavaScript достиг 558 КБ на мобильных и 613 КБ на десктопе . Многие страницы теперь сначала загружают HTML-оболочку, а затем подтягивают сами данные фоновыми запросами.
Представьте, например, что вы скрапите систему бронирования отелей. Классический метод по HTML возвращает пустые контейнеры. Selenium может отрисовать номера, но каждая страница грузится медленно, а при пагинации появляются ошибки. Если цены на номера, даты, названия и доступность приходят фоновым JSON-запросом, вы можете забирать эти данные прямо с эндпоинта.
В этом руководстве показано, как изучить страницу, найти запрос к API, протестировать его в Postman, преобразовать в Python, обработать пагинацию и сохранить результаты в CSV.

Используйте резидентные прокси NodeMaven, липкие сессии, геотаргетинг и Scraping Browser для более сложных страниц с обилием JavaScript. Начните с 750 МБ для $3.50.
Коротко: что выбрать, веб-скрапинг или API?
Использование API-скрейпинг когда страница загружает чистый JSON через Fetch/XHR и к эндпоинту можно безопасно обращаться.
Пробуй HTML-скрейпинг когда данные уже присутствуют в исходном коде страницы.
Использование Браузерный скрейпинг когда сценарию нужна отрисовка JavaScript, клики, прокрутка, скриншоты, отправка форм или визуальная отладка.
Видимый в DevTools фронтенд-эндпоинт сам по себе не даёт права использовать его в больших объёмах. Прежде чем строить крупный скрапер, проверьте условия сайта, правила доступа и наличие официального API.
Веб-скрапинг и API: в чём разница?
Веб-скрейпинг извлекает данные со страницы сайта. Скрапинг API отправляет запрос к тому эндпоинту, через который сайт загружает структурированные данные, обычно в JSON.
| Метод | Как это работает | Лучшая точка старта |
| HTML-скрейпинг | Загружает HTML страницы и разбирает элементы | Статичные страницы |
| Браузерный скрейпинг | Открывает страницу через Selenium или Playwright | Страницы с активным JavaScript, клики, прокрутка |
| Скрапинг API-эндпоинтов | Обращается напрямую к фоновому JSON-запросу | Динамические страницы с видимыми данными XHR/fetch |
In a basic веб-скрейпинг сценарии скрапер скачивает HTML и извлекает текст по селекторам. Руководство NodeMaven веб-скрапинг на Python описывает этот классический подход с Requests и BeautifulSoup.
Скрапинг эндпоинтов API работает иначе. Браузер загружает страницу, JavaScript запрашивает данные у сервера, и сервер возвращает JSON. Вместо того чтобы скрапить отрисованную карточку или таблицу, ваш скрипт на Python отправляет похожий запрос и читает ответ в JSON.
Именно поэтому скрапинг API может быть быстрее и чище. Данные уже структурированы ещё до того, как сайт превратит их в визуальные элементы.
Официальные API против фронтенд-эндпоинтов
Официальный API документирован и создан для разработчиков. Обычно у него есть аутентификация, лимиты запросов, версионирование, примеры ответов и правила использования.
Фронтенд-эндпоинт — это запрос, который интерфейс самого сайта отправляет в фоне. Часто его видно в Chrome DevTools во вкладке Fetch/XHR. Он может возвращать чистый JSON, но способен измениться без предупреждения и зависеть от cookie, токенов, заголовков или подписанных данных.
Используйте официальный API, если он даёт нужные вам поля и лимиты. Используйте фронтенд-эндпоинт только тогда, когда доступ разрешён и запрос можно надёжно воспроизвести. Используйте браузерный скрапинг, если эндпоинт слишком сложно воспроизвести или сценарий зависит от отрисованной страницы.
Почему скрапинг API-эндпоинтов бывает быстрее Selenium
Система бронирования отелей может показывать карточки номеров только после того, как JavaScript загрузит цены и доступность из API. Selenium умеет дожидаться отрисованных карточек, но каждый запуск приносит запуск браузера, выполнение JavaScript, изображения, CSS, всплывающие окна и логику ожидания.
Скрапинг API-эндпоинтов обходит этот отрисованный интерфейс, когда те же данные уже доступны в формате JSON. Вместо того чтобы ждать, пока браузер отобразит карточку номера, ваш скрипт запрашивает данные, стоящие за ней.
Это часто всплывает в обсуждениях разработчиков. В треде на Stack Overflow о медленном скрапинге на Seleniumв ответе указывают на накладные расходы браузера в Selenium и рекомендуют изучить вкладку Network, чтобы воспроизвести исходные запросы на Python.
Такой подход помогает сократить:
- длинные CSS-селекторы для каждого поля
- ожидание отрисовки элементов
- сбои браузера
- медленную пагинацию
- громоздкий разбор HTML
- высокую нагрузку на CPU и память
Но скрапинг API-эндпоинтов подходит не всегда. Некоторые эндпоинты требуют закрытой авторизации, CSRF-значений, одноразовых токенов, подписанных payload'ов или строгой проверки сессии. Другие меняются без предупреждения, потому что созданы для фронтенда сайта, а не для внешних разработчиков.
Если эндпоинт закрыт или в работе нужны клики, скриншоты, прокрутка, формы или визуальная отладка, используйте браузерный скрапинг. Playwright и Selenium оба открывают страницу, выполняют JavaScript и работают с отрисованным результатом.
Для браузерного скрапинга, которому нужны выполнение в облаке, прокси, обработка CAPTCHA, отладка через Live Browser и записи сессий, браузер для скрапинга NodeMaven дает вам управляемую среду Chrome вместо того, чтобы поддерживать браузерный стек самостоятельно.
Если у сайта есть официальный API с нужными вам полями и лимитами, начните с него. Он задокументирован, версионируется и обычно проще в поддержке , чем фронтенд-эндпоинт, найденный в DevTools.
Используйте резидентные прокси NodeMaven, липкие сессии, геотаргетинг и Scraping Browser для более сложных страниц с обилием JavaScript. Начните с 750 МБ для $3.50.
Подготовка к руководству: инструменты и демо-сайт
Для этого руководства вам понадобятся четыре вещи:
- Хром
- Postman
- Python 3
- Запросы
Для демонстрации используйте Quotes to Scrape с бесконечной прокруткой. Он создан для практики скрапинга, загружает данные динамически и предоставляет чистый JSON-эндпоинт.
Перед запуском примеров на Python вы установите Requests внутри виртуального окружения. Это позволяет избежать ошибки externally-managed-environment, которая может возникать в новых версиях Python из Homebrew.
Шаг 1: найдите API-эндпоинт в Chrome DevTools
Открыть Quotes to Scrape с бесконечной прокруткой in Chrome.
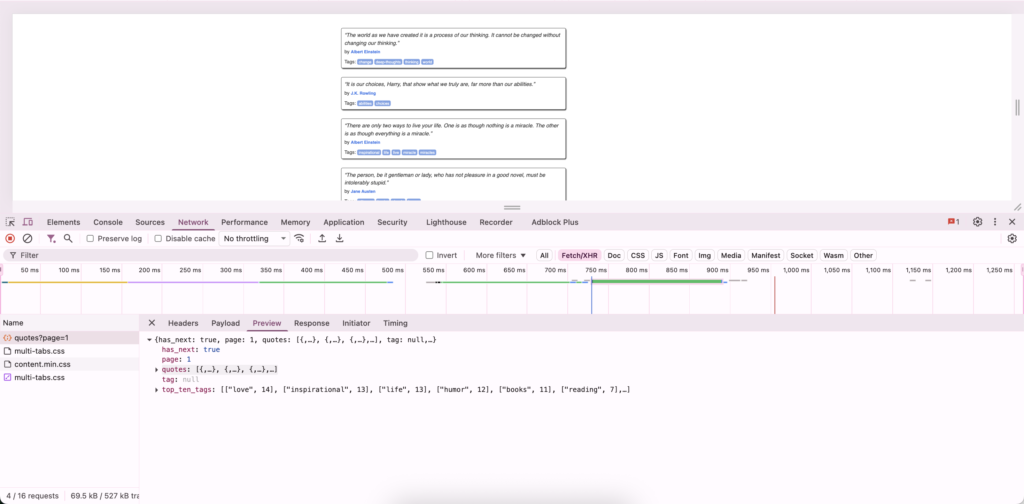
Кликните по странице правой кнопкой мыши и выберите Проверить. Откройте Сеть вкладку, затем нажмите Fetch/XHR. Перезагрузите страницу или прокручивайте её, пока не появятся новые запросы.
В списке запросов нажмите quotes?page=1. Затем откройте вкладку Preview . Если вы видите поля вроде has_next, page, quotes и top_ten_tags, значит вы нашли JSON-ответ, который стоит за страницей.
В этой демонстрации эндпоинт такой:
The page=1 part controls pagination. Later, the Python script will change that value to collect page 2, page 3, and the rest of the available results.
Chrome’s Справочник по возможностям панели Network объясняет, как панель Network показывает запросы, отправленные страницей, включая Fetch/XHR-запросы и предпросмотр ответов.
Шаг 2: протестируйте эндпоинт в Postman
After you find the request in Chrome DevTools, right-click quotes?page=1 and choose:
Copy > Copy as cURL
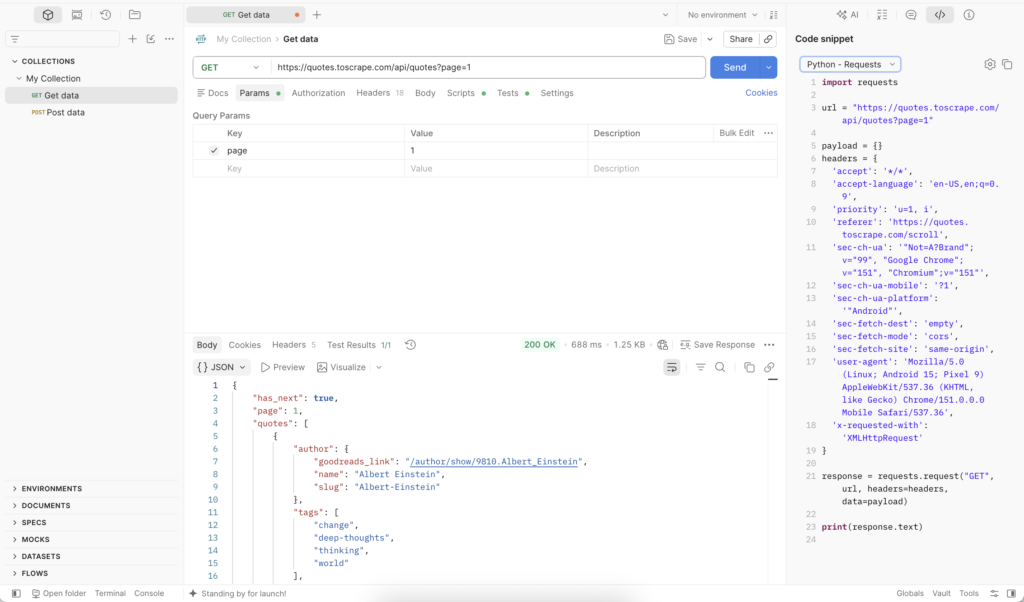
Откройте Postman и вставьте скопированный cURL в поле URL запроса. В этой демонстрации Postman извлекает эндпоинт и показывает его так:
Оставьте метод GET и нажмите Send.
Если в панели ответа отображается 200 OK и JSON-поля вроде has_next, page и quotes, значит эндпоинт работает и вне браузера.
Также проверьте Params tab. Postman separates page=1 into a query parameter. This is important because the Python script will later change that value to page=2, page=3, and so on.
Теперь откройте в Postman панель Code snippet и выберите Python – Requests. Postman сгенерирует код на Python для того же запроса, включая URL эндпоинта, метод, заголовки и структуру payload.
Для реальных сайтов используйте сгенерированный код как отправную точку. Заголовки, cookie, токены и значения payload могут определять, будет ли эндпоинт работать вне браузера.
Что проверить перед переходом к Python
Перед тем как писать код, изучите запрос в Postman.
Начните с Request URL. Это адрес эндпоинта. Затем проверьте Метод, обычно GET или POST.
GET-запрос часто хранит значения в URL. POST-запрос может отправлять отдельный payload.
Далее изучите параметры запроса. In this demo, page=1 controls pagination. On real websites, parameters can control the search term, category, city, date, currency, sort order, offset, or cursor.
Для POST-запросов откройте вкладку Payload . Сайты бронирования могут отправлять такие значения, как destination, checkin, checkout, adults, currency и page. Эндпоинты интернет-магазинов могут использовать query, category, sort, limit и offset.
Перед переходом к Python проверьте:
- Headers: content type, accept, user agent и заголовки, специфичные для запроса
- Cookie или токены: значения сессии, CSRF-токены или значения авторизации
- Структура ответа: где в JSON находятся нужные вам поля
- Поля пагинации: такие значения, как page, offset, cursor, has_next или next
Если позже запрос на Python не сработает, чаще всего не хватает как раз одного из этих элементов.
Шаг 3: создайте и выполните первый запрос на Python
Откройте редактор кода, например VS Code, Cursor или TextEdit в режиме обычного текста.
Создайте новый файл с именем:
Вставьте Python – Requests код, сгенерированный Postman, в файл:
Сохраните файл.
Откройте Terminal и перейдите в папку, куда вы сохранили файл. Например, если вы сохранили его на рабочем столе, выполните:
Создайте виртуальное окружение:
Активируйте его:
Установите Requests внутри виртуального окружения:
Запустите скрипт:
Если всё работает, терминал выведет JSON-ответ.
На этом этапе цель проста: убедиться, что Python может отправить тот же запрос, который вы протестировали в Postman.
Если вы видите ошибку о том, что файл не найден, проверьте имя файла. На Mac TextEdit может сохранить файл в формате .rtf.
Шаг 4: соберите все страницы и сохраните в CSV
Go back to quotes_api_scraper.py.
Now replace the test code with a full scraper. This version keeps the same headers from Postman, changes the page value automatically, and saves the results to quotes.csv.
Сохраните файл и запустите его снова:
Теперь в той же папке должен появиться новый файл:
quotes.csv
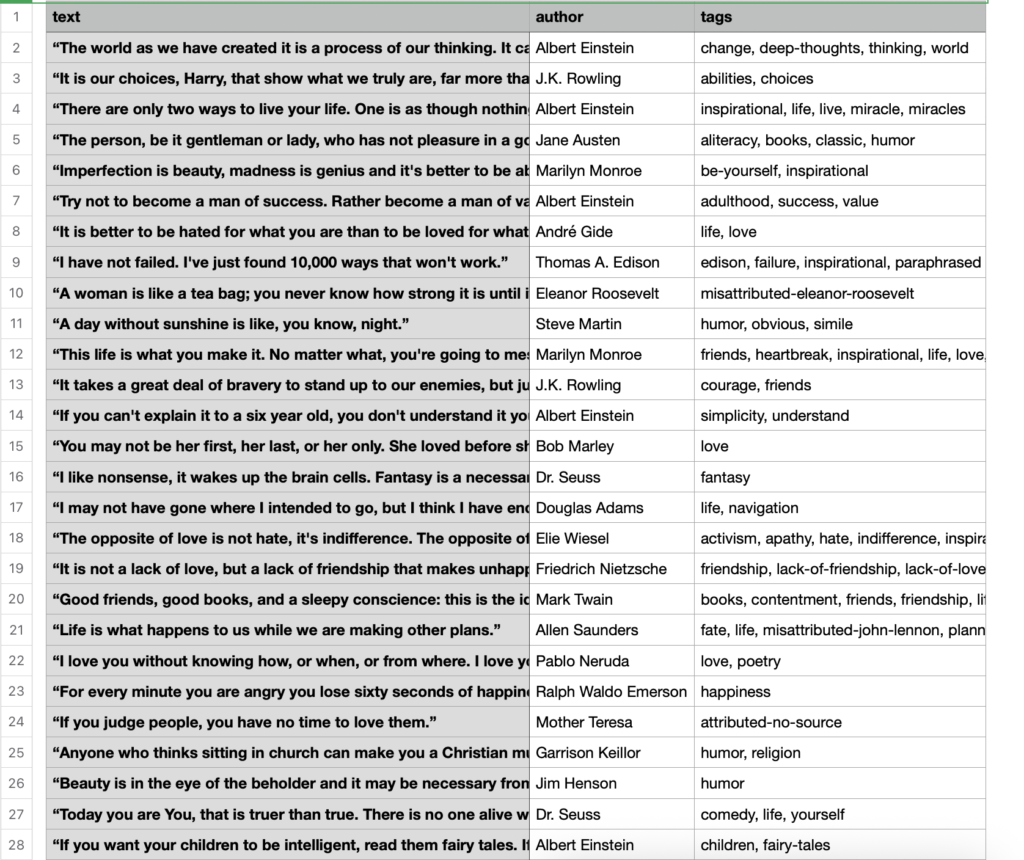
Этот CSV и есть итоговый результат руководства. В нём собраны текст цитаты, имя автора и теги со всех доступных страниц.
На реальных сайтах сначала оставьте заголовки, сгенерированные Postman. Когда скрапер заработает, можно удалять необязательные заголовки по одному и проверять снова.
Зачем при скрапинге API нужны прокси, стабильные сессии и геотаргетинг
Скрапинг через API-эндпоинты быстрее, чем автоматизация браузера, но запросы всё равно идут с определённого IP-адреса. На небольших объёмах обычного подключения может хватить. На больших объёмах повторяющиеся запросы к эндпоинту упираются в лимиты частоты запросов, региональные ответы или проверки репутации IP.
Для независимых запросов к эндпоинтам по множеству страниц ротационные резидентские прокси помогают распределить трафик по чистым пользовательским IP. Для систем бронирования, локальных каталогов или мониторинга цен sticky сессии помогают сохранять окружение запроса неизменным на протяжении всей задачи.
Использование ISP прокси на регулярный мониторинг с одного стабильного IP. Для Python-скриптов в разделе NodeMaven прокси для Python описаны типовые схемы настройки. Если эндпоинт возвращает локальные цены, доступность доставки или региональные объявления, Таргетинг на уровне ZIP помогает привязать набор данных к нужной локации.
Для эндпоинта бронирования цены, налоги, доступность и валюта могут меняться в зависимости от страны, города, cookies и состояния сессии. Если скрапер переключает регионы между запросами, CSV может оказаться несогласованным, даже когда код отрабатывает корректно.
Используйте резидентные прокси NodeMaven, липкие сессии, геотаргетинг и Scraping Browser для более сложных страниц с обилием JavaScript. Начните с 750 МБ для $3.50.
Частые проблемы при скрапинге API-эндпоинтов
Эндпоинт работает в Chrome, но не работает в Python
Обычно это значит, что запросу из Python не хватает того, что браузер отправлял автоматически.
Проверьте заголовки, cookies, CSRF-токены, значения авторизации, поля подписи запроса и полезную нагрузку POST. Сравните рабочий запрос в DevTools с запросом из Python бок о бок.
A Обсуждение на Stack Overflow о скрапинге динамической веб-таблицы наглядно показывает эту схему. XHR-запросам требовался токен верификации со страницы, прежде чем API-запрос начинал работать.
API возвращает 401, 403 или 429
401 или 403 обычно означает, что эндпоинту нужна авторизация, действительная сессия или подпись запроса. Не пытайтесь взломать приватные эндпоинты.
429 означает слишком много запросов. Снизьте темп, добавьте повторы с экспоненциальной задержкой и не отправляйте все запросы с одного IP. Для крупных задач по сбору публичных данных ротационные резидентские прокси позволяют распределить запросы по более чистым пользовательским IP, тогда как ISP прокси лучше подходят для регулярных проверок, где нужен один стабильный адрес.
JSON пустой или в нём не хватает полей
Запросу может не хватать даты, региона, поискового запроса, номера страницы, фильтра, валюты или значения в полезной нагрузке.
Откройте Payload и Query String Parameters во вкладках DevTools. Затем измените одно значение и отправьте запрос заново в Postman. Так вы поймёте, какой параметр отвечает за какую часть ответа.
Эндпоинт меняется
Фронтенд-эндпоинты не являются стабильными контрактами. Сайт может переименовать маршрут, изменить полезную нагрузку, убрать поле или добавить проверку токена без предупреждения.
Добавьте валидацию ответа перед сохранением данных. Если обязательного поля нет, запишите в лог URL, код статуса, фрагмент ответа иметку вместо того, чтобы писать битые строки в CSV.
Если эндпоинт зависит от кликов, отрисованного контента, приватных токенов или постоянного состояния браузера, вернитесь к браузерному скрапингу. Для таких случаев браузер для скрапинга NodeMaven может запускать настоящий облачный браузер с прокси NodeMaven, поддержкой CAPTCHA, отладкой в Live Browser и записями сессий.
Используйте резидентные прокси NodeMaven, липкие сессии, геотаргетинг и Scraping Browser для более сложных страниц с обилием JavaScript. Начните с 750 МБ для $3.50.
Заключение
Прежде чем писать скрапер на Selenium, загляните во вкладку Network. Если страница уже подгружает данные через JSON-эндпоинт, скрапинг через API сэкономит время и даст более чистый результат.
Начните с одного запроса. Протестируйте его в Postman. Переведите его в Python. Добавьте пагинацию. Сохраните данные в CSV. Затем проверьте лимиты запросов, регион, cookies, поведение сессии и качество прокси, прежде чем масштабировать задачу.
Для небольших тестов хватит и собственного подключения. Для регулярного скрапинга через API, локальных цен, результатов бронирования, наличия товаров или облачных задач на Python чистые прокси и стабильные сессии помогают избежать ситуации, когда рабочий скрипт выдает «грязные» данные.