Руководство по скрапингу с Playwright: автоматизация браузера через прокси


Скрапинг с Playwright означает использование настоящего браузера, чтобы открыть сайт, дождаться отрисовки JavaScript, взаимодействовать с элементами страницы и извлечь данные из итогового состояния страницы. Это хороший вариант, когда простой HTTP-запрос не видит того же контента, который отображается в Chrome.
Локального скрипта Playwright достаточно для тестирования личных автоматизаций или скрапинга небольшой публичной страницы. Промышленный скрапинг сложнее. Как только рабочему процессу требуются запуск в облаке, таргетинг по регионам, обход CAPTCHA, профили браузера, записи сессий или сессии через прокси, сам браузер становится лишь одной частью инфраструктуры.
Здесь и пригодится браузер для скрапинга NodeMaven — он запускает настоящий браузер Chrome на инфраструктуре NodeMaven, направляет сессию через прокси NodeMaven и предоставляет Playwright CDP-адрес для подключения. Отдельной платы за использование браузера нет: вы платите только за прокси-трафик, использованный во время сессии, вместо того чтобы тратить время и серверные ресурсы на создание и поддержку собственной браузерной инфраструктуры.
Веб-автоматизация также становится всё более требовательным к инфраструктуре. В отчёте Apify State of Web Scraping 2026, 65,8% специалистов по скрапингу сообщили, что увеличили использование прокси, тогда как 58,3% увеличили расходы на прокси по сравнению с прошлым годом. Применительно к скрапингу с Playwright это объясняет, почему многие команды сегодня уделяют внимание репутации IP, стабильности сессий, сигналам браузера и согласованности геолокации ещё до масштабирования.
В этом руководстве объясняется, когда использовать Playwright, когда напрямую использовать NodeMaven Scraping Browser, как подключить Playwright по CDP и как выбрать подходящую конфигурацию прокси для скрапинга e-commerce, мониторинга цен, сайтов с большим объёмом JavaScript и облачной автоматизации.

Лучшая конфигурация скрапинга на Playwright под ваш сценарий
| Сценарий | Лучший вариант для старта |
| Локальное тестирование своих скриптов | Локальный Playwright |
| Обычный сайт на React или с большим объёмом JavaScript | Сначала локальный Playwright; переходите на Scraping Browser при блокировках, CAPTCHA или проблемах с развёртыванием в облаке |
| Страницы товаров в e-commerce | Шаблон Scraping Browser от NodeMaven для e-commerce с резидентными прокси |
| Мониторинг цен каждые 15 минут | Scraping Browser с закреплённой сессией или сохранённым профилем браузера |
| Запуск в облаке или задачи по расписанию | API Scraping Browser от NodeMaven |
| Результаты поиска параллельно | Сначала API или HTTP-скрапер; Playwright только там, где нужен рендеринг |
| Страницы под защитой Cloudflare | Scraping Browser с Extra Stealth, CAPTCHA Solver и Cloudflare Web Bot Auth, где это применимо |
| No-code сценарий | NodeMaven AI Prompt или готовые шаблоны |
| Конвейер данных для AI или RAG | Структурированный вывод JSON из Scraping Browser |
В этой статье «Playwright с прокси» может означать две схемы работы. Вы можете настроить прокси вручную в локальном скрипте Playwrightили использовать браузер для скрапинга NodeMaven, где браузерное окружение, маршрутизация через прокси, обход CAPTCHA, Live Browser и инструменты отладки уже настроены за вас.
Что такое скрапинг с Playwright?
Playwright — это фреймворк для автоматизации браузера. Он умеет управлять Chromium, Firefox и WebKit, нажимать кнопки, заполнять формы, прокручивать страницы, ждать появления элементов, делать скриншоты и извлекать данные из отрисованного DOM.
Для скрапинга Playwright обычно выбирают тогда, когда страница зависит от поведения браузера.
Простой скрапер загружает HTML. Скрапер на Playwright открывает страницу как браузер, выполняет скрипты, ждёт загрузки интерфейса и только затем извлекает данные.
Благодаря этому Playwright хорошо подходит для:
- страниц на React, Vue, Angular и других страниц с большим объёмом JavaScript
- страниц товаров с динамическими ценами или остатками
- страницы поиска с фильтрами и бесконечной прокруткой
- сценарии, где нужны клики, формы или переход по страницам
- скриншоты и визуальные проверки
- страницы, где на результат влияют геолокация, файлы cookie или состояние сессии
Если вы только начинаете со скрапингом, начните с более простых целей. Руководство NodeMaven веб-скрапинг на Python описывает базовый процесс до того, как вы перейдёте к автоматизации браузера. Также посмотрите наше руководство по Playwright MCP.
Зачем подключать Playwright к NodeMaven Scraping Browser?
Подключать Playwright для каждой задачи скрапинга не обязательно. Если шаблон в панели управления или AI Prompt уже даёт нужные вам данные, оставайтесь в NodeMaven Scraping Browser. Вы можете выбрать шаблон под свой сценарий, запустить браузер, наблюдать за Live Browser, смотреть консоль и выгружать структурированные результаты, не написав ни одного полноценного скрипта.
Подключайте Playwright, когда скрапер должен стать частью вашей собственной системы. Например, вашему бэкенду нужно брать URL из базы данных, запускать задачи скрапинга по расписанию, отправлять JSON во внутреннюю панель управления или передавать свежие веб-данные в AI/RAG-пайплайн.
Используйте панель управления для быстрых тестов:
- запустите шаблон для e-commerce, обогащения B2B-данных, недвижимости или мониторинга цен
- напишите AI Prompt без кода
- следите за страницей в Live Browser
- смотрите вывод консоли и структурированные результаты
- скачайте скриншот, HTML-файл или быстрый экспорт
Используйте Playwright со Scraping Browser для контроля в продакшене:
- запускайте скрапер со своего бэкенда
- планируйте задачи через cron, очереди или воркеры
- скрапьте множество URL из своей базы данных
- переиспользуйте существующий код на Playwright
- отправляйте извлечённый JSON в своё приложение, панель управления или AI-пайплайн
- управляйте навигацией, ожиданиями, кликами, скриншотами и валидацией прямо в коде
Коротко говоря, NodeMaven Scraping Browser обеспечивает работу облачной браузерной среды, включая прокси, настройки антидетекта, решение CAPTCHA, Live Browser и записи сессий. Playwright управляет этим браузером из вашего кода когда шаблонов или AI Prompt уже недостаточно.
Проверьте наше руководство по как использовать Scraping Browser если вам не нужно подключать его к своей системе и вы хотите быстро приступить к скрапингу.
Локальный Playwright против NodeMaven Scraping Browser
Локальный Playwright дает полный контроль на вашей собственной машине. Это подходящее место, чтобы разобраться, составить селекторы, протестировать ожидания и убедиться, что процесс работает.
Проблемы обычно начинаются, когда тот же скрапер переносится на VPS, CI-воркер или продакшен-сервер. Теперь браузер работает с облачного IP. Целевой сайт может отдавать другой контент, больше CAPTCHA, более медленные ответы или страницы с блокировкой, которых при локальном тестировании не было.
| Настройка | Что вы обслуживаете | Better For |
| Локальный Playwright | установка браузера, локальный IP, скрипты, селекторы | обучение, небольшие тесты, личная автоматизация |
| Playwright на вашем VPS | сервер, зависимости браузера, настройка прокси, логи, масштабирование | команды с ресурсами DevOps |
| браузер для скрапинга NodeMaven | облачный браузер, маршрутизация через прокси, настройки антидетекта, Live Browser, записи сессий | продакшен-скрапинг, региональные проверки, отладка, задания по расписанию |
NodeMaven сначала запускает браузер. Playwright подключается к уже запущенному браузеру через chromium.connectOverCDP(cdpUrl). Это значит, что ваш скрипт по-прежнему управляет страницей, но сам браузер работает внутри управляемой среды NodeMaven.
Как подключить Playwright к NodeMaven Scraping Browser
Чтобы подключить Playwright к NodeMaven Scraping Browser, вам понадобятся два значения из панели управления NodeMaven:
- API-токен Scraping Browser со страницы Scraping Browser Overview
- Пароль прокси из ваших учетных данных прокси NodeMaven
API-токен авторизует запрос на создание сессии браузера. Пароль прокси позволяет NodeMaven направлять браузер через выбранную конфигурацию прокси.
Шаг 1: Скопируйте API-токен Scraping Browser
Откройте панель управления NodeMaven и перейдите в Scraping Browser → Overview. В Browser API скопируйте свой API-токен.
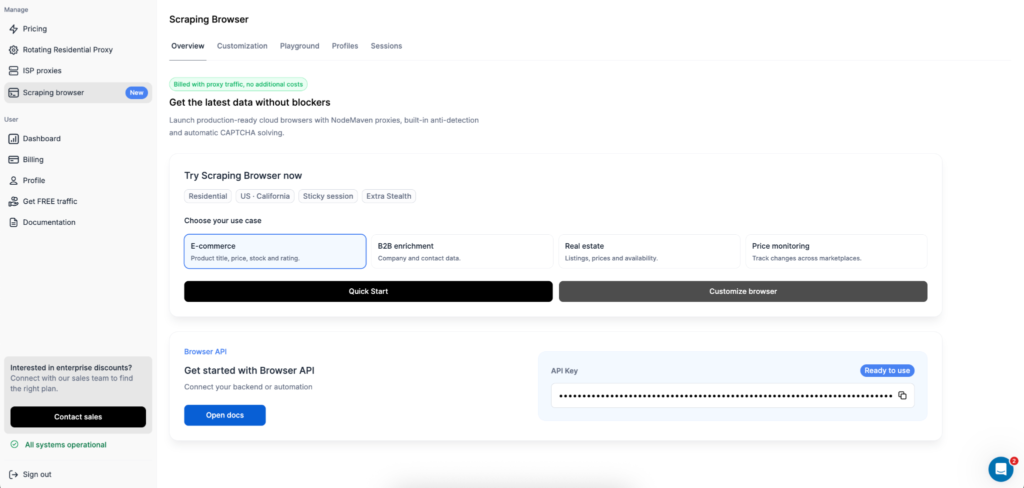
Храните этот токен в секрете. Он работает как пароль для создания сессий браузера и управления ими.
В API-запросах токен передается как bearer-токен:
Шаг 2: Скопируйте пароль прокси
Затем скопируйте пароль прокси из ваших учетных данных прокси NodeMaven.
Вы будете использовать это значение в поле proxy_password при создании сессии Scraping Browser.
Шаг 3: Установите Playwright Core
Установите playwright-core в свой проект:
Используйте playwright-core, потому что NodeMaven уже запускает браузер Chrome в облаке. Вашему скрипту нужно лишь подключиться к этому браузеру.
Шаг 4: создание сессии браузера
Создайте сессию браузера через Scraping Browser API.
В ответе будут ID сессии, статус и CDP URL.
Скопируйте cdp_url. Это ссылка для подключения, которую будет использовать Playwright.
Шаг 5: подключение Playwright по CDP
Теперь подключите Playwright к запущенной сессии браузера NodeMaven.
Главное отличие от локального Playwright — строка запуска браузера.
Локальный Playwright обычно запускается так:
В NodeMaven Scraping Browser браузер уже работает в облаке:
Шаг 6: извлечение данных со страницы
После подключения Playwright пишите селекторы так же, как в обычном скрапере на Playwright.
Всегда проверяйте результат перед сохранением. Браузер может успешно загрузить страницу и всё равно вернуть страницу с CAPTCHA, пустую выдачу, страницу не того региона или экран входа.
Пример: скрапинг страницы интернет-магазина с помощью Playwright
E-commerce страницы — естественный сценарий для скрапинга на Playwright, поскольку данные о товарах часто зависят от JavaScript, файлов cookie, местоположения, правил наличия и настроек доставки.
Типичный процесс выглядит так:
- Откройте страницу поиска или категории.
- Дождитесь появления карточек товаров.
- Извлеките названия, цены, рейтинги, сведения о наличии и URL.
- Сохраните скриншот для отладки.
- Верните структурированный JSON.
Замените селекторы на те, что используются на вашем целевом сайте. Для сценариев в стиле Amazon изучите конкретную страницу и регион до масштабирования: вёрстка, блоки цен, сообщения о доставке и спонсорские блоки могут различаться.
О смежных сценариях читайте в руководствах NodeMaven по теме Скрейпинг цен, как скрапить Amazon, и созданию Трекер цен Amazon на Python.
Нужны ли прокси для скрапинга на Playwright?
Прокси нужны для скрапинга на Playwright не всегда.
Если вы тестируете личный скрипт локально, открываете небольшую публичную страницу или автоматизируете собственный сайт, обычного подключения может быть достаточно.
Прокси становятся частью схемы, когда рабочий процесс зависит от:
- региональных цен, товарных карточек, результатов поиска или наличия
- регулярного скрапинга одного и того же сайта
- запуска в облаке с VPS или CI-воркера
- профилей браузера, которым нужна стабильная геолокация
- параллельных задач скрапинга
- публичных сайтов, которые проверяют репутацию IP
Для сбора публичных данных веб-скрейпинг прокси помогают сохранять стабильность сетевого уровня. Локальный скрипт может работать с домашнего подключения, но давать сбой при запуске в облачной инфраструктуре, потому что целевой сайт иначе относится к дата-центровым маршрутам.
Для многих задач скрапинга на Playwright резидентские прокси стоит попробовать в первую очередь, так как они направляют трафик через сети обычных пользователей. Для независимых запросов к страницам ротационные резидентские прокси могут распределять запросы между разными IP.
Главное - подобрать поведение прокси под сценарий скрапинга. Не используйте агрессивную ротацию в сессии, которая зависит от файлов cookie, корзины, пагинации, настроек геолокации или авторизации.
Оптимальная настройка прокси для скрапинга на Playwright
Публичные страницы интернет-магазинов
Для публичных страниц товаров, категорий и проверки наличия начните с резидентские прокси и стабильного региона.
Если сайт меняет контент в зависимости от местоположения, выберите нужную страну, регион, город или почтовый индекс до запуска сессии браузера. Так скрапер получит ту же версию страницы, которую увидел бы реальный пользователь из этой местности.
Для исследования товаров по множеству не связанных между собой URL ротация подходит. Для страницы категории, прохода по пагинации или сессии покупок используйте sticky-сессию, чтобы сайт не увидел смену IP посреди пути.
Мониторинг цен каждые 15 минут
Мониторинг цен требует стабильности больше, чем частой ротации.
Если вы проверяете один и тот же товар каждые 15 минут, случайная смена IP может давать противоречивые результаты. Страница может показать другой адрес доставки, валюту, вариант доставки или сообщение о наличии.
Используйте sticky-сессию или сохранённый профиль браузера. Записывайте регион, исходный URL, отметку времени, цену, текст о наличии и путь к скриншоту для каждого запуска. Если цена изменилась, вы сможете понять, изменилась ли сама страница или скрапер собрал другую региональную версию.
Результаты поиска параллельно
Скрапинг результатов поиска может обойтись дорого при работе с Playwright, потому что каждая сессия браузера загружает много ресурсов.
Если у целевого сайта есть API или он отдаёт пригодный статический HTML, начните с этого. Используйте Playwright только для тех страниц, где действительно нужен рендеринг в браузере.
Если рендеринг в браузере необходим, делайте сессии короткими, блокируйте ненужные ресурсы там, где это разрешено, и не запускайте больше браузеров, чем может себе позволить ваш процесс. Аналитика трафика NodeMaven поможет увидеть, какие домены расходуют трафик прокси.
Страницы под защитой Cloudflare
Некоторые сайты используют Cloudflare или другие антибот-системы. Для разрешённых сценариев NodeMaven Scraping Browser может запускать сессии с Extra Stealth, Сервис решения CAPTCHA, и Cloudflare Web Bot Auth для сайтов-участников.
Такая конфигурация может повысить стабильность в поддерживаемых сценариях, но ни один браузер и ни одна настройка прокси не гарантируют доступ к любому сайту. Если целевой сайт блокирует автоматизацию, изучите его правила, снизьте частоту запросов, откройте страницу вручную в Live Browser и убедитесь, что скрапер собирает только разрешённые публичные данные.
Сценарии с мобильным трафиком
Использование мобильные прокси. когда целевой сайт ведёт себя иначе с трафиком мобильных операторов или когда нужны проверки, специфичные для мобильных устройств.
Для обычного десктопного скрапинга проще использовать резидентные прокси или закреплённые сессии. Мобильные прокси имеют смысл для mobile-first платформ, тестирования приложений, верификации рекламы или случаев, когда трафик операторской сети является частью процесса.
Профили браузера для скрапинга на Playwright
Профиль браузера сохраняет его состояние между сессиями. В NodeMaven Scraping Browser профили могут сохранять файлы cookie, локальное хранилище, кэш, историю браузера и авторизованное состояние на сайте.
Используйте профили, когда процессу нужна непрерывность:
- личный кабинет с авторизацией, где автоматизация разрешена
- выбранный на сайте региональный параметр
- регулярный мониторинг цен
- многошаговая форма, зависящая от сохранённых файлов cookie
- долгоживущая среда для исследований
Каждый аккаунт включает до 10 профилей браузера по умолчанию.
Профиль и сессия — это не одно и то же. Сессия — это один запуск браузера с ограниченным временем жизни. Профиль — это сохранённое состояние браузера, которое можно использовать повторно в разных сессиях.
При удалении профиля сохранённые данные браузера стираются. Если целевой сайт сам завершает вашу сессию входа, профиль не сможет удерживать авторизацию бесконечно.
Отладка скрапинга на Playwright в NodeMaven
Скрапинг на Playwright часто ломается так, что по одним логам причину не понять. Скрипт может завершиться по тайм-ауту, а на самой странице окажется CAPTCHA, баннер о файлах cookie, страница блокировки по региону, отсутствующий селектор или медленно загружающийся компонент.
NodeMaven Scraping Browser даёт несколько способов изучить ход выполнения:
- Live Browser показывает автоматизацию в реальном времени.
- Вывод консоли показывает логи скрипта и извлеченный JSON.
- Скриншоты помогают сравнить успешные и неудачные страницы.
- HTML export позволяет изучить фактически полученную страницу.
- Записи сессий помогают разобрать завершенные запуски.
- Вкладка Sessions показывает активные, завершенные и неудачные сессии браузера.
Максимальный TTL каждой сессии браузера составляет 30 минут, а записи сессий и данные отладки хранятся три дня по умолчанию.
Если запуск завершился ошибкой, сначала посмотрите на видимую страницу. Если страница верная, исправьте селекторы или ожидания. Если страница неверная, проверьте локацию прокси, состояние профиля, обработку CAPTCHA, файлы cookie и тайминг запросов.
Панель управления или API для скрапинга с Playwright
Используйте Scraping Browser в панели управления пока вы еще выстраиваете рабочий процесс.
В панели управления можно выбрать шаблон, настроить окружение браузера, написать AI-промпт, отредактировать скрипты Playwright или Puppeteer, наблюдать за Live Browser, изучить вывод консоли и просмотреть структурированные результаты.
Используйте API, когда рабочий процесс готов к запуску из вашей собственной системы.
API подходит для следующих задач:
- задачи по расписанию
- серверные пайплайны скрапинга
- очереди и краулеры
- регулярный мониторинг
- сбор данных для AI или RAG
- продакшн-процессы, которым нужно программное управление сессиями
Для задач по расписанию и запуска в облаке создайте сессию браузера через API, подключитесь с помощью Playwright по CDP, выполните извлечение данных, сохраните результат и закройте сессию. Таймингом управляет ваш планировщик. NodeMaven берет на себя облачный браузер и прокси-окружение.
Цены и лимиты
Scraping Browser не имеет отдельной платы за использование браузера для подходящих пользователей NodeMaven. Вы платите только за трафик ротируемых прокси NodeMaven, переданный во время сессий браузера.
Работа браузера, Live Browser, AI-запросы, решение CAPTCHA и записи сессий не тарифицируются отдельно.
Неудачные или заблокированные автоматизации всё равно расходуют трафик прокси, уже переданный во время сессии. Live Browser не добавляет отдельных расходов на трафик, а записи входят в тариф.
NodeMaven ротационный резидентский и мобильный прокси тарифы начинаются от $2.20/GB. Новые пользователи также могут Начните с 750 МБ трафика резидентных и мобильных прокси за $3.50, чего достаточно, чтобы протестировать небольшой сценарий скрапинга на Playwright перед масштабированием.
Пользователи могут отслеживать трафик в разделе Дашборд → Разбивка по доменам → Scraping Browser. Настраиваемого лимита трафика на одну сессию сейчас нет, но активные сессии можно в любой момент завершить вручную.
| Лимит | Включено по умолчанию |
| Профили браузера | Up to 10 |
| Активные сессии браузера | До 50 одновременно |
| Максимальный TTL сессии | 30 минут |
| Хранение записей | 3 days |
Если вашему сценарию нужны более высокие лимиты или более длительные сессии, свяжитесь с поддержкой NodeMaven и опишите задачу.
Чек-лист скрапинга с Playwright перед масштабированием
Перед запуском масштабного скрапера на Playwright протестируйте сценарий поэтапно.
Начните локально или в Playground с одного URL. Убедитесь, что страница отрисовывается, селекторы работают, а в результате есть нужные поля. Затем протестируйте с целевой локацией прокси и настройками сессии.
Для продакшн-запусков сохраняйте следующие проверки:
- сохраняйте исходный URL, отметку времени, регион и извлечённый JSON
- отслеживайте CAPTCHA, страницы входа, отказа в доступе и пустые страницы
- сохраняйте скриншоты неудачных запусков
- используйте sticky-сессии, когда на страницу влияют файлы cookie или настройки локации
- используйте ротацию только тогда, когда каждый запрос независим
- отслеживайте трафик прокси по доменам
- сравнивайте поведение локально и в облаке перед масштабированием
- завершайте зависшие сессии, а не позволяйте им расходовать трафик
Для AI- и RAG-пайплайнов проверяйте JSON перед передачей дальше. Некачественные собранные данные незаметно становятся некачественным контекстом для модели.
Заключение
Playwright — мощный инструмент скрапинга, когда для сайта нужен настоящий браузер. Он умеет отрисовывать JavaScript, проходить по сценариям на страницах, ждать появления динамических элементов и извлекать данные из того же состояния страницы, которое видит пользователь.
Для небольших локальных тестов достаточно обычного Playwright. Для рабочих процессов в продакшене браузер для скрапинга NodeMaven снижает объём работы с браузерной инфраструктурой, маршрутизацией прокси, настройками локации, обработкой CAPTCHA, профилями, логами, скриншотами и записями.
Используйте панель управления, когда вам нужны шаблоны, AI Prompt, Live Browser и быстрое тестирование. Подключайте Playwright по CDP, когда рабочий процесс должен запускаться из вашего бэкенда, планировщика, очереди или конвейера данных.