
Скрапинг данных e-commerce: полное руководство по методам, инструментам и туториал на Python


E-commerce скрапинг данных помогает командам ценообразования, продавцам на маркетплейсах и менеджерам каталогов собирать публичную информацию о товарах в магазинах конкурентов. Надёжный рабочий процесс фиксирует идентификатор товара, цену, статус скидки, вариант, локацию и временную метку , а не сохраняет одну видимую цену.
Начинайте с официального API или товарного фида, если они дают нужные поля. Для динамических магазинов изучите разрешённые публичные JSON-ответы. Используйте браузер для скрапинга NodeMaven , когда рабочий процесс требует отрисованных страниц, взаимодействия с браузером, предложений, зависящих от локации, или настройки без кода.
Согласно данным отчёту Бюро переписи населения США о квартальных розничных продажах в e-commerce за II квартал 2026 года, розничные продажи в e-commerce в США достигли 340,2 млрд долларов за квартал и составили 17,1% от общего объёма розничных продаж. Цены на товары, акции, варианты и региональные предложения могут быстро меняться, поэтому для каждого наблюдения нужны чёткие правила сравнения.
Ключевые выводы
- Начните с инструмента официального источника, затем протестируйте разрешённые публичные JSON-ответы.
- Совмещать данные из листинга товаров и данные о вариантах на уровне размеров в одну проверенную запись о предложении.
- Сохранять цену, статус скидки, ID товара, размер, рынок и временную метку вместе с каждым зафиксированным предложением.
- Использовать управляемый браузерный воркфлоу для отрендеренных страниц, сохранения профилей, визуальной проверки или облачного выполнения.
Выберите метод сбора данных e-commerce
Начните с браузер для скрапинга NodeMaven когда вам нужен no-code воркфлоу, отрендеренные страницы, фильтры товаров, выбор вариантов, предложения с привязкой к региону или регулярная браузерная автоматизация. Соберите воркфлоу на основе готового шаблона, AI-промпта на обычном языке или кода, не настраивая локальный браузер.
Scraping Browser включает прокси NodeMaven, управляемую антидетект-защиту, автоматическое решение CAPTCHA, переиспользуемые профили, Live Browser и записи сессий. Отдельной платы за браузер нет. Вы платите только за трафик прокси с ротацией, использованный во время сессий.

Попробуйте NodeMaven Scraping Browser с платным пробным доступом за $3.50, в который входит 750 MB трафика резидентных и мобильных прокси. В Scraping Browser нет отдельной платы за браузер: среда выполнения браузера, шаблоны, AI-промпты, решение CAPTCHA, Live Browser и записи сессий включены в стоимость подходящего прокси-трафика.
Подходящий метод по-прежнему зависит от ритейлера и от того, какие поля нужно собрать.
| Метод | Наилучшее соответствие | Роль NodeMaven |
|---|---|---|
| Браузер для скрейпинга | Сбор данных без кода, магазины с большим объёмом JavaScript, фильтры, пагинация, выбранные варианты товаров, предложения с привязкой к региону и регулярные воркфлоу | Встроенные прокси, решение CAPTCHA, AI-промпты, шаблоны, Live Browser, записи сессий и переиспользуемые профили |
| Официальный API или фид | Ритейлер или поставщик предоставляет документированный доступ и необходимые поля товаров | Настройка прокси обычно не требуется |
| Разрешённый публичный JSON | Проверенный ответ фронтенда содержит данные о товарах и остаётся достаточно стабильным для мониторинга | Используйте прокси NodeMaven для региональных результатов или повторяющихся запросов |
| HTML-парсинг | Нужные поля присутствуют в исходном коде страницы | Используйте прокси, когда местоположение или непрерывность запросов влияют на отображаемый результат |
Выбирайте самый лёгкий метод, который надёжно возвращает нужные поля. Проверьте один товар и одно местоположение, прежде чем масштабировать сбор на всю категорию. Техническое сравнение прямых запросов и сбора через браузер приведено в руководстве NodeMaven «веб-скрапинг или API».
Настройте контекст прокси для регионального и повторного сбора
Предложение по товару может меняться в зависимости от страны, города, ZIP-кода, валюты, места доставки или состояния сессии. Задайте местоположение сбора до сравнения предложений, а затем сохраняйте этот контекст в каждой записи.
Для повторяющихся разрешённых запросов NodeMaven резидентские прокси предоставлять таргетинг на уровне страны, города, ISP и ZIP. Закреплённые сессии позволяют сохранять один и тот же IP на протяжении связанного сценария просмотра. Сессии с ротацией подходят для независимых запросов по товарам, которым не нужно общее состояние браузера.
Используйте один и тот же рыночный контекст при проверке страницы в браузере, публичного ответа и экспортированной записи. Цену из одного местоположения нельзя напрямую сравнивать с предложением, собранным из другого.
Начните с платный пробный период за $3.50NodeMaven, который включает 750 MB трафика резидентных и мобильных прокси. Протестируйте запросы с учётом местоположения, закреплённые сессии и вашу интеграцию на Python, прежде чем переходить на более крупный тариф.
Определите данные о товарах и предложениях до сбора страниц
A запись о товаре описывает сам товар:
- Название
- Бренд
- ID товара у ритейлера
- ID в каталоге
- Цвет
- Вариант
- Размер
- GTIN
Ан наблюдение предложения описывает предложение, показанное для этого товара в указанное время и в указанном месте:
- Текущая цена
- Статус распродажи
- Валюта
- Страна рынка
- URL источника
- Контекст сессии или локации
- Время фиксации
Например, «Nike Shox Z, цвет HQ7540-011, женский размер 7» — это вариант товара. Акционное предложение $78.97 для этого варианта в магазине для США в 09:00 UTC — это наблюдение предложения.
Сравнивайте эквивалентные предложения
Указанной цене нужен контекст товара. Два товара с одинаковым названием могут отличаться размером, цветом, размером упаковки, состоянием, продавцом, условиями доставки или рынком.
Прежде чем сравнивать конкурентов, подтвердите:
- Идентификация товара: ID товара у ритейлера, бренд, название и модель
- Идентификация варианта: размер, цвет, SKU и GTIN, если они доступны
- Тип цены: обычная цена, цена со скидкой, цена для участников или предложение на маркетплейсе
- Местоположение: страна, город, ZIP-код, валюта и контекст доставки
- Время: временная метка сбора и частота сбора данных
Зона Обзор National Academies по ценовым данным, собранным с веб-сайтов рассматривает такие риски, как выбросы, релевантность продавца, изменения на сайтах и результаты, зависящие от местоположения. Эти проверки должны быть частью любого процесса мониторинга цен или наличия товаров.
Постройте рабочий процесс на Python для публичных данных о товарах
В этом руководстве на примере публичной страницы результатов поиска женских кроссовок Nike показано, как найти ответ с данными о товарах и сопоставить его поля. В примере на Python используются обобщённые URL-заполнители. Заменяйте их только после проверки официального источника или разрешённого публичного ответа для того ритейлера, с которого вы собираете данные.
Рабочий процесс выглядит так:
Ответ со списком товаров → идентификатор товара и цена → данные SKU и GTIN по размерам → проверенная запись предложения → история в CSV или SQL
Шаг 1. Найдите запрос поиска товаров
Откройте публичную страницу поиска товаров или категории. В этом примере на странице отображаются женские кроссовки Nike.
Открыть Chrome DevTools, выбрать Сеть, а затем выбрать Fetch/XHR. Перезагрузите страницу или выполните поиск. На панели Network появятся запросы, инициированные страницей со списком товаров.
Найдите запрос, который возвращает товары, показанные на странице. На странице результатов Nike нужный запрос называется Продукты.
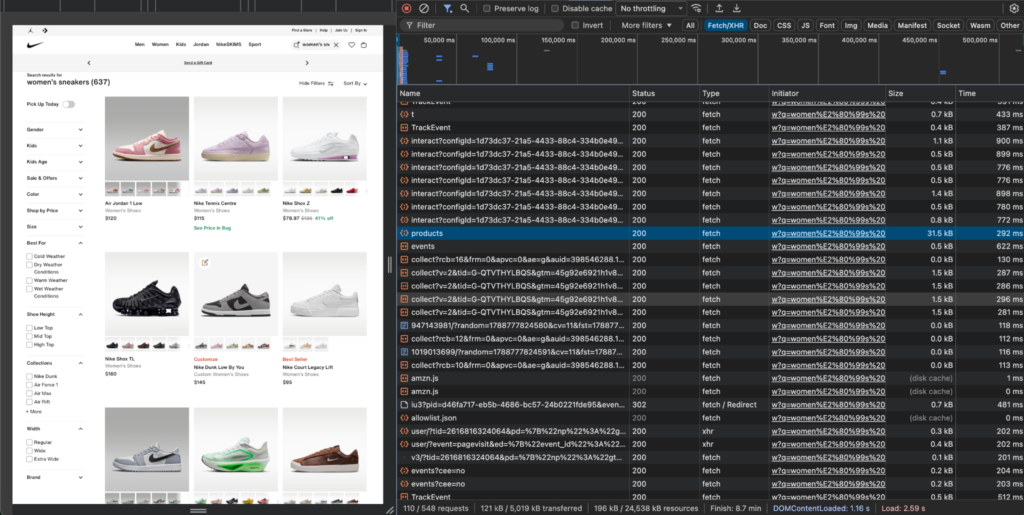
В списке запросов могут также присутствовать вызовы аналитики, отслеживания событий и рекомендаций. Прежде чем открывать ответ, выберите запрос, связанный с видимыми карточками товаров.
Шаг 2. Сопоставьте поля ответа
Ответ Nike Продукты ответ содержит массив с именем hydratedProducts. Каждый объект товара содержит ID товара у ретейлера, название, текущую цену, статус распродажи, код цвета и страну рынка.
Сопоставьте поля с записью предложения следующим образом:
| Поле JSON Nike | Выходное поле |
|---|---|
hydratedProducts[].productId | retailer_product_id |
hydratedProducts[].catalogId | catalog_id |
hydratedProducts[].name | имя |
hydratedProducts[].currentPrice | current_price |
hydratedProducts[].isOnSale | is_on_sale |
hydratedProducts[].color | colour_code |
hydratedProducts[].country | market_country |
hydratedProducts[].cloudProductId | cloud_product_id |
Сверьте цену с видимой карточкой товара, прежде чем добавлять её в набор данных. В этом примере карточка Nike Shox Z показывает $78.97, что соответствует currentPrice: 78.97 в ответе.
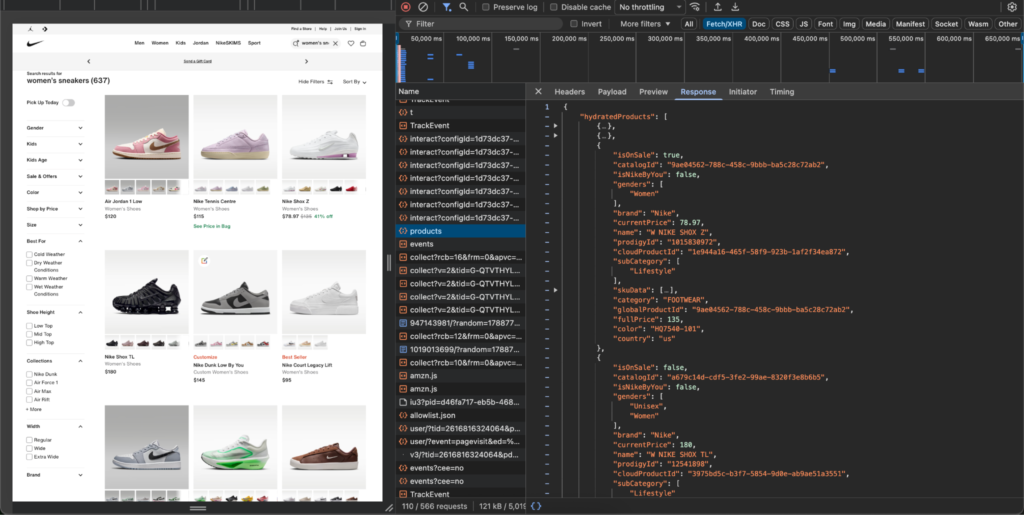
Шаг 3: Проверьте один товар, прежде чем собирать всю категорию
Проверьте один товар, прежде чем собирать всю категорию целиком.
На примере Nike Shox Z убедитесь в следующем:
- Видимая карточка товара соответствует
hydratedProducts[].name. - Цена в карточке соответствует
hydratedProducts[].currentPrice. - Запись содержит
productId,catalogId, иcolor. - Значение
Странав ответе соответствует отслеживаемому рынку. - Цена корректно помечена как обычная или акционная через
isOnSale. - Один из размеров, показанных на странице товара, соответствует значению
skuData[].sizeв ответе.
Совпадение одного лишь ID товара не доказывает, что цена готова к сравнению. Название товара, цена, цвет, рынок, статус распродажи и выбранный размер должны относиться к одному и тому же предложению.
Если цена или выбранный размер отличаются от того, что показано на странице, проверьте выбранный цвет, размер, валюту, страну, отображение налогов, статус акции и контекст кэшированного ответа, прежде чем сохранять запись.
Шаг 4. Настройте Python
Создайте виртуальное окружение и установите пакеты, которые используются в примере.
В коде ниже используются обобщённый placeholder эндпоинта и структура ответа Nike, показанная на скриншотах. Не копируйте URL эндпоинта из этой статьи в рабочий скрипт сбора данных.
Настройте сессию перед отправкой запросов
Для разрешённого сценария, который требует конкретного рынка или регулярного сбора данных, настройте прокси-сессию до запроса данных о товарах. Добавьте учётные данные NodeMaven из личного кабинета, а не копируйте их в общий скрипт.
Используйте локацию, соответствующую отслеживаемому рынку. Для многошагового сценария в браузере используйте закреплённую сессию, когда одна и та же локация и контекст сессии должны оставаться неизменными. Для независимых запросов по товарам резидентные прокси с ротацией дадут свежие IP без переноса состояния браузера между товарами.
Начните с платный пробный период за $3.50NodeMaven, который включает 750 MB трафика резидентных и мобильных прокси. Протестируйте запросы с учётом местоположения, закреплённые сессии и вашу интеграцию на Python, прежде чем переходить на более крупный тариф.
Шаг 5. Создайте модель данных товара и вспомогательные функции для запросов
Ответ Nike задаёт структуру данных списка товаров, но на скриншотах не видно параметра пагинации. Начните с одного проверенного ответа.
Некоторые ритейлеры используют страница, offset, старт, cursor, или лимит для пагинации. Добавляйте цикл пагинации только после изучения запроса списка товаров и подтверждения нужного параметра.
Эта модель хранит ID товара у ритейлера, текущую цену, статус распродажи, цвет, рынок и время сбора вместе. Эти поля позволяют выполнять последующие сравнения, не теряя контекст, стоящий за ценой.
Шаг 6. Добавьте данные о вариантах из ответа по товару
Ответ Nike по товару содержит массив skuData с вариантами товара по размерам. Каждая запись включает отображаемый размер, SKU ритейлера и GTIN.
Сопоставьте поля уровня размера с записью коллекции следующим образом:
| Поле JSON Nike | Выходное поле |
|---|---|
hydratedProducts[].skuData[].size | variant_size |
hydratedProducts[].skuData[].sku | variant_sku |
hydratedProducts[].skuData[].gtin | variant_gtin |
Используйте выбранную страницу товара, чтобы проверить одну запись. Например, убедитесь, что кнопка размера W 5 / M 3.5 на странице совпадает с полем размер в JSON-ответе.
Теперь каждая экспортированная строка может представлять одну комбинацию «товар + размер». Это упрощает сопоставление товаров у разных ритейлеров и позволяет рабочему процессу мониторинга различать два предложения одной и той же модели обуви в разных размерах.
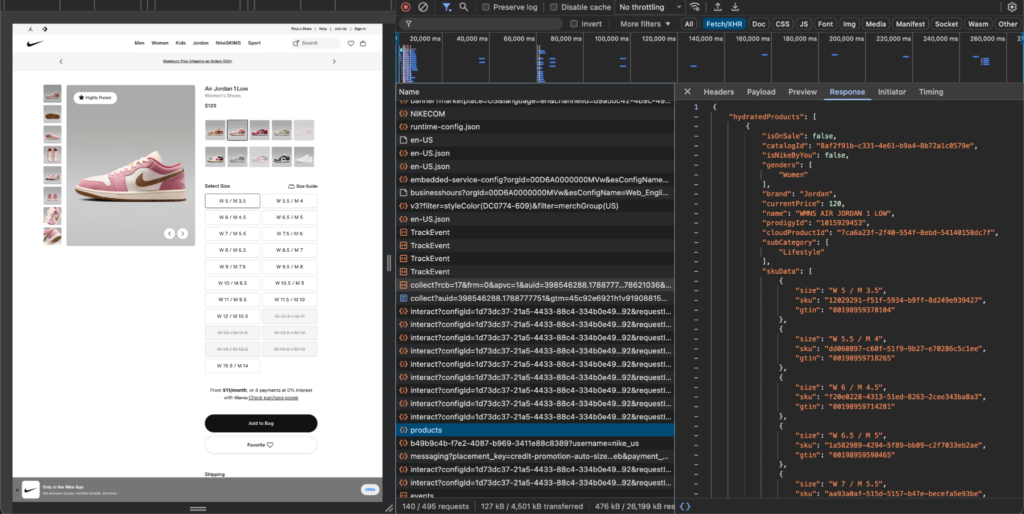
Показанный здесь ответ не содержит явного поля наличия или статуса запасов. Не делайте вывод о наличии товара по одному лишь присутствию размера в skuData. Добавляйте данные о наличии только тогда, когда разрешённый ответ содержит однозначное поле, например inStock, наличие, инвентарь, или availability_status.
Шаг 7: Запустите полный процесс сбора и экспортируйте CSV
После проверки карты полей запросите разрешённый ответ со списком товаров, извлеките записи о товарах и экспортируйте валидные наблюдения в CSV-файл.
Ожидаемый вывод в терминале:
Пример CSV-вывода:
CSV служит простым слоем проверки перед построением более крупного пайплайна мониторинга. Прежде чем использовать данные в анализе цен, просмотрите строки с отсутствующими ID товаров, ценами, рыночными данными или неожиданной структурой ответа.
Шаг 8: Сохраняйте наблюдения в SQL
CSV хорошо подходит на этапе первичной проверки. База данных SQL поддерживает историю цен, сравнение ритейлеров, анализ по категориям и отчётность по конкретным локациям.
По мере роста системы храните идентификацию товара отдельно от отдельных наблюдений. Один товар со временем может давать множество записей о цене по разным цветам, размерам, странам и ритейлерам.
Сохраняйте ссылку на сырой ответ или небольшую контрольную выборку при каждом запуске сбора. Когда ритейлер меняет структуру ответа, эти записи помогают команде обновить сопоставление полей, не путая изменение формата с реальным движением цены.
После проверки рабочего процесса с одиночными запросами асинхронные запросы в Python помогут контролируемо масштабировать сбор.
Проверяйте каждое наблюдение за предложением
Ответ 200 подтверждает лишь то, что сервер ответил на запрос. Для сопоставимого наблюдения за предложением нужны совпадающие идентификация товара, вариант, тип цены, валюта, локация и временная метка.
Для предложений на маркетплейсах добавьте продавца, состояние товара, способ выполнения заказа и данные о доставке. Для товаров, продаваемых в разных количествах, рассчитайте цену за единицу, прежде чем сравнивать предложения.
Когда рабочий процесс использует связанную сессию браузера, на результаты влияет постоянство локации. Для независимых запросов товаров можно использовать ротацию. Многошаговая навигация часто требует одной стабильной сессии до завершения процесса. Прочитайте руководство NodeMaven по ротации прокси , прежде чем выбирать поведение сессии.
Используйте NodeMaven Scraping Browser для сбора e-commerce данных через браузер
NodeMaven Scraping Browser подходит далеко не только для страниц, требующих кликов или ввода ZIP-кода. Он даёт e-commerce-командам управляемый облачный браузер для сбора публичных данных о товарах через отрендеренные страницы, профили браузера, автоматизацию по расписанию, сессии с привязкой к локации и визуальную отладку.
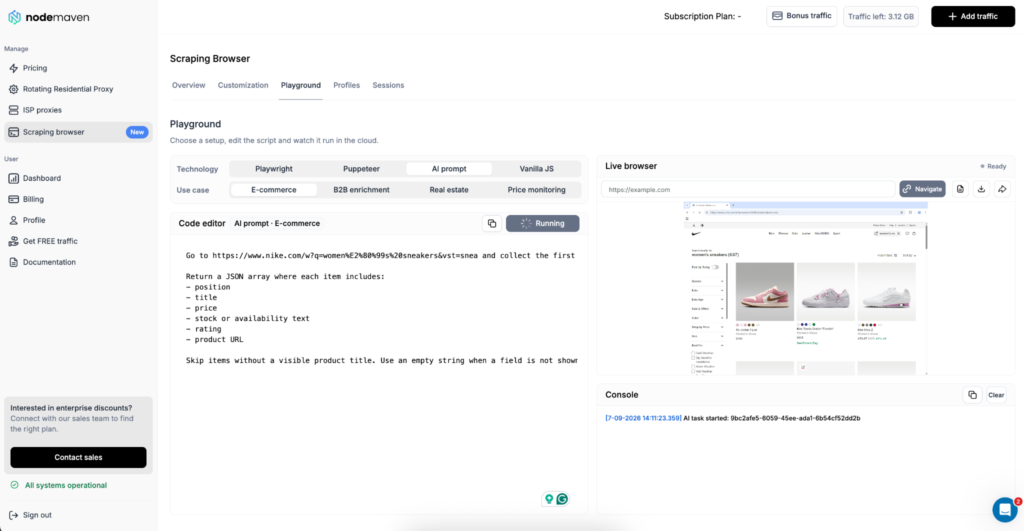
Используйте Scraping Browser, когда рабочий процесс требует:
- рендеринга JavaScript страницы категорий и товаров
- Поиск товаров, фильтры и пагинация
- Выбор варианта, размера, цвета или количества
- Настройки ZIP-кода, города, страны, валюты или места доставки
- Регулярный мониторинг цен, каталога, запусков или наличия на складе
- Многоразовые профили браузера, сохраняющие файлы cookie и локальные настройки
- Live Browser, вывод консоли, скриншоты и записи для отладки
- Playwright, Puppeteer, чистый JavaScript или AI-промпты на обычном языке
Публичный JSON-ответ может быть самым экономичным путём для стабильного разрешённого эндпоинта. Scraping Browser также подходит командам, которые предпочитают полноценный браузерный workflow для целевого сайта, особенно когда страницы каталога меняются, локация влияет на предложение или команде нужна визуальная проверка перед запуском workflow в продакшен.
Практическая настройка выглядит так:
- Выберите шаблон для e-commerce или мониторинга цен.
- Задайте тип прокси, локацию, поведение сессии и настройки браузера.
- Протестируйте сбор данных со страниц категорий, поиска или товаров в Playground.
- Проверьте отрендеренный результат в Live Browser.
- Подтвердите ID товара, выбранный вариант, цену, исходный URL и контекст локации.
- Сохраните workflow как многоразовый профиль или подключитесь через CDP из Playwright или Puppeteer.
- Запускайте его по расписанию из бэкенда, очереди или системы мониторинга.
Зона Руководство по NodeMaven Scraping Browser охватывает шаблоны, профили, настройки локации, сессии, Live Browser и подключения через CDP.
Хотите собирать данные e-commerce, не выстраивая браузерный стек самостоятельно? Попробуйте NodeMaven Scraping Browser с платный пробный период за $3.50, включая 750 MB трафика резидентных и мобильных прокси. Среда выполнения браузера, шаблоны, AI-промпты, решение CAPTCHA, Live Browser и записи сессий включены в подходящий прокси-трафик. Попробовать Scraping Browser за $3.50
Вывод: выбирайте самый лёгкий надёжный рабочий процесс
Выберите метод сбора, который возвращает нужные поля товара с минимальными затратами на поддержку. Начните с официального фида, если он доступен. Используйте разрешённый публичный JSON-ответ, если запрос отдаёт стабильную структуру полей. Добавьте парсинг HTML, если поля присутствуют в исходном коде страницы.
Для команд, которым нужен no-code-подход, отрисованные страницы, взаимодействие с браузером, региональные предложения товаров или регулярные рабочие процессы, NodeMaven Scraping Browser сочетает автоматизацию браузера со встроенной работой с прокси и визуальной отладкой. Для сбора данных на Python резидентные прокси NodeMaven обеспечивают рабочему процессу единый рыночный контекст и стабильные сессии там, где этого требует логика ритейлера.
Проверьте один товар, один вариант и одну локацию, прежде чем добавлять целую категорию или другого ритейлера. Сохраняйте ID товара, цену, цвет, размер, рынок, исходный URL и временную метку с каждым наблюдением.
Попробуйте NodeMaven Scraping Browser с платным пробным доступом за $3.50, в который входит 750 MB трафика резидентных и мобильных прокси. В Scraping Browser нет отдельной платы за браузер: среда выполнения браузера, шаблоны, AI-промпты, решение CAPTCHA, Live Browser и записи сессий включены в стоимость подходящего прокси-трафика.


