Что такое парсинг данных: как работает и законно ли это


Коротко
- Парсингом называют автоматический сбор данных с сайтов, из приложений и файлов с переводом в таблицу, базу данных или JSON.
- Парсер работает в 5 шагов: получает задачу, загружает страницу, извлекает поля по селекторам, очищает данные и сохраняет результат.
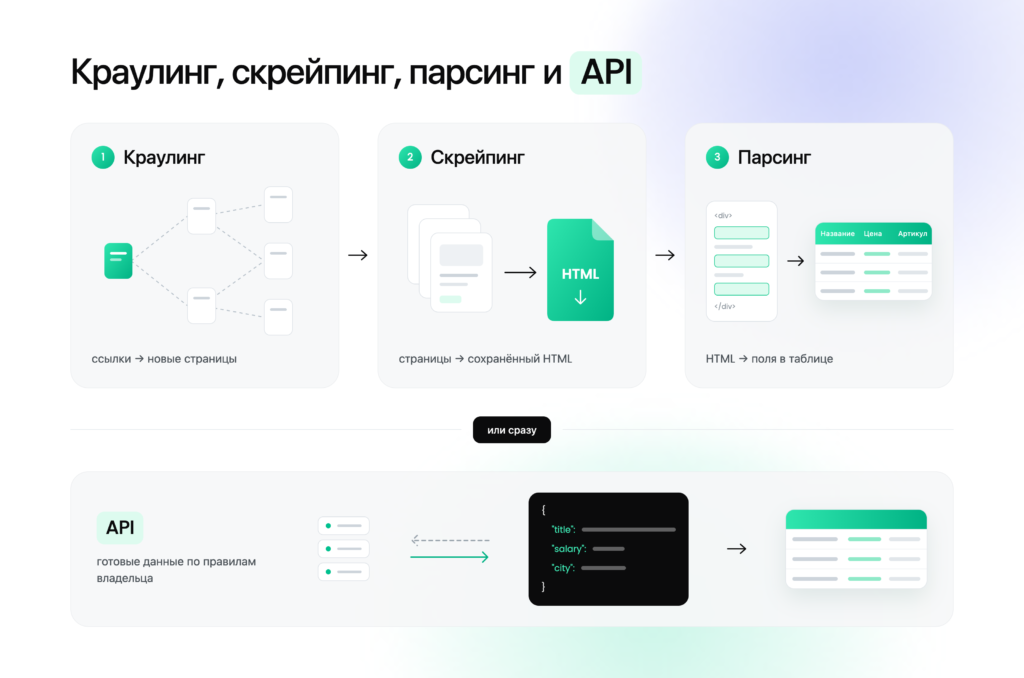
- Краулинг обходит сайт по ссылкам, скрейпинг скачивает страницы, а парсинг достаёт из них конкретные поля. В русском языке парсингом обычно называют всю цепочку.
- Чаще всего парсят цены, ассортимент, отзывы, поисковую выдачу и вакансии.
- В России сбор общедоступной информации не запрещён. Персональные данные нельзя собирать без согласия человека даже из открытых профилей: это правило действует с 1 марта 2021 года.
- Без программирования начать можно с функции IMPORTXML в Google Таблицах, а первый парсер с кодом проще всего написать на Python с библиотеками requests и BeautifulSoup.
Парсингом называют автоматический сбор данных с сайтов, из приложений или файлов и их перевод в удобный формат: таблицу, базу данных, JSON. Если совсем по-простому, парсер похож на стажёра, который переносит данные из браузера в Excel. Только работает в сотни раз быстрее, не устаёт и не путает строки.
В статье:
- Что такое парсинг простыми словами
- Как работает парсер
- Зачем нужен парсинг
- Виды парсинга
- Законно ли парсить данные в России
- Почему сайты блокируют парсеры
- Как спарсить данные: три способа
- Сколько стоит парсинг
- Плюсы и ограничения
- Частые вопросы
Что такое парсинг простыми словами
Допустим, вы хотите знать, сколько стоят ваши 3 000 товаров у пяти конкурентов. Вручную это выглядит так: открыть карточку, скопировать название и цену, вставить в таблицу и повторить ещё 14 999 раз. На это уйдёт неделя. Парсер справится за час, а завтра утром сделает всё заново, пока вы пьёте кофе.
Слово пришло из английского: to parse значит «разбирать по частям, анализировать структуру». Парсер берёт страницу, которую сделали для людей, с картинками, баннерами и кнопкой «Купить», и вынимает из неё только то, что вам нужно: название, цену, рейтинг, ссылку.
Это не взлом, поскольку парсер видит ровно то же, что и любой посетитель сайта. Просто человек за вечер откроет десяток страниц, а парсер за то же время откроет тысячи.
Парсинг, скрапинг, краулинг и API: в чём разница
Четыре термина, которые часто путают:
| Термин | Что делает | Пример |
|---|---|---|
| Краулинг | Обходит сайт по ссылкам и находит страницы | Поисковый робот Яндекса ищет новые страницы |
| Скрейпинг | Скачивает содержимое найденных страниц | Сохранить HTML всех карточек каталога |
| Парсинг | Достаёт из содержимого нужные поля и структурирует их | Выгрузить из HTML цену, название и артикул в таблицу |
| API | Отдаёт данные напрямую в готовом виде, по правилам владельца | Запросить список вакансий через API hh.ru |
На практике краулинг, скрейпинг и парсинг работают одной связкой, и в русском языке всё это называют парсингом. Если у сайта есть открытый API, начинайте с него. Это как попросить у магазина прайс-лист вместо того, чтобы ходить по залу с блокнотом: данные уже разложены по полочкам, и владелец сам разрешил их брать.
Парсинг в программировании
У слова есть и второе, программистское значение. Парсингом называют разбор любой строки или файла по правилам: так программа читает JSON-ответ сервера, а компилятор разбирает ваш код.
Как работает парсер: 5 шагов
Любой парсер проходит одни и те же этапы.
- Получает задачу. Список страниц или стартовый адрес и правила: какие поля нужны и где они лежат на странице.
- Загружает страницу. Отправляет запрос на сервер, как это делает браузер, и получает HTML-код или ответ API.
- Извлекает данные. Находит нужные элементы по селекторам (CSS или XPath) и вынимает текст, ссылки, числа.
- Очищает и нормализует. Убирает пробелы и лишние символы, приводит цены к числам, даты к одному формату, удаляет дубли.
- Сохраняет результат. В CSV, Excel, Google Таблицу, базу данных или отправляет дальше по API.
Если парсинг регулярный, сверху добавляется расписание. Например, парсер запускается каждый день в 6 утра и присылает уведомление, если конкурент поменял цену.
Статичные страницы, JavaScript и скрытый API
Каким инструментом парсить, зависит от того, как устроен сайт. Вариантов три.
- Статичный HTML. Все данные уже есть в коде страницы, который отдаёт сервер. Самый простой случай: хватит обычного HTTP-запроса и библиотеки для разбора HTML.
- Страницы на JavaScript. Сервер отдаёт пустой шаблон, а товары подгружаются скриптом после открытия. Обычный запрос их не увидит. Нужен headless-браузер или библиотека автоматизации (Playwright, Puppeteer, Selenium), который откроет страницу как настоящий пользователь и дождётся загрузки.
- Скрытый API. Многие современные сайты сами получают данные из своего внутреннего API в формате JSON. Его можно найти во вкладке Network в инструментах разработчика браузера. Если такой запрос есть, парсить его проще и быстрее, чем HTML: данные уже структурированы.
Понять, какой у вас случай, можно за минуту. Откройте страницу, нажмите Ctrl+U (просмотр кода) и поищите нужную цену. Нашлась: HTML статичный, вам повезло. Не нашлась: данные подгружает скрипт, и придётся повозиться.
Зачем нужен парсинг: задачи по сферам
Парсинг нужен там, где решения зависят от чужих данных, а данные меняются быстрее, чем человек успевает их переписать.
| Сфера | Что собирают | Пример задачи |
|---|---|---|
| Интернет-магазины и маркетплейсы | Цены, остатки, ассортимент, отзывы конкурентов | Каждое утро сравнивать цены на 5 000 товаров и автоматически корректировать свои |
| Маркетинг | Упоминания бренда, отзывы, посты, рекламные креативы | Находить новые отзывы о компании на 10 площадках и отвечать в течение дня |
| SEO | Поисковую выдачу, подсказки, метатеги, ссылки | Собрать семантику из подсказок и проверить свой сайт на битые ссылки |
| Аналитика и финансы | Курсы, котировки, новости, отчётность компаний | Отслеживать цены на сырьё и строить прогноз закупок |
| HR и рекрутинг | Вакансии и зарплаты на рынке | Понять вилку зарплат для позиции перед наймом |
| Недвижимость и авто | Объявления, цены за метр, сроки экспозиции | Найти объекты ниже рыночной цены в первые часы после публикации |
| Разработка ИИ | Тексты, изображения, открытые датасеты | Собрать корпус документов для обучения или дообучения модели |
Есть сценарий, о котором часто забывают: парсинг собственного сайта. Он быстро находит карточки без описания, страницы с ошибками, дубли, а заодно товары, которые на складе закончились, а на витрине всё ещё продаются.
Виды парсинга
Парсинг делят по двум признакам: откуда берут данные и чем их собирают.
По источнику
- Сайты и интернет-магазины: каталоги, карточки товаров, цены, характеристики. С них начинается большинство задач.
- Поисковая выдача: позиции сайтов по запросам, сниппеты, подсказки, блоки «Люди также ищут». Это нужно для SEO и анализа конкурентов.
- Маркетплейсы: цены, продажи, отзывы и позиции товаров в поиске площадки. Крупные площадки активно защищаются от парсинга, поэтому здесь чаще используют специализированные сервисы аналитики.
- Соцсети и мессенджеры: посты, комментарии, участники открытых сообществ. Почти всё, что вы здесь соберёте, будет персональными данными (подробнее в разделе про закон).
- Документы и файлы: PDF, Excel, сканы. Например, можно вытащить таблицы из сотни отчётов в одну базу.
По способу
- Свой код: Python, JavaScript и другие языки. Это самый гибкий вариант, но нужен разработчик и постоянная поддержка, потому что сайты меняют вёрстку и парсер ломается.
- Конструкторы без кода и десктопные программы: вы кликаете мышкой по нужным элементам страницы, и программа собирает их сама. Подходят для разовых и несложных задач.
- Облачные сервисы: парсер работает на серверах сервиса по расписанию, а вы получаете готовую выгрузку. Удобно для регулярного мониторинга.
- Официальные API: строго говоря, это не парсинг, зато данные приходят в готовом виде, без риска блокировок, и владелец сайта сам разрешил их брать.
- LLM-парсинг: страницу отдают нейросети и просят вернуть нужные поля в JSON. Селекторы писать не нужно, и при смене вёрстки такой парсер ломается реже. Минусы: на больших объёмах это дороже, а нейросеть иногда ошибается, поэтому результат нужно проверять.
Законно ли парсить данные в России
Короткий ответ: собирать общедоступную информацию можно. Проблемы начинаются, когда вы берёте не те данные или делаете с ними что-то не то.
Право свободно искать и получать информацию закреплено в статье 29 Конституции и статье 7 закона «Об информации» (149-ФЗ). Парсер просто делает то же, что человек, только быстрее. Но рядом с этими статьями действуют другие нормы, и о них лучше узнать до запуска, а не из претензии от юристов конкурента.
Что можно и что нельзя
| Обычно можно | Рискованно или запрещено |
|---|---|
| Цены, ассортимент, характеристики товаров | Персональные данные: ФИО, телефоны, email, профили людей |
| Открытая статистика и справочные данные | Данные за авторизацией, платным доступом или капчей, которую приходится обходить |
| Поисковая выдача и метатеги | Копирование чужих текстов и фото на свой сайт |
| Свой собственный сайт | Нагрузка, из-за которой сайт падает или тормозит |
| Данные через официальный API | Извлечение всей или существенной части чужой базы данных |
Персональные данные и 152-ФЗ
Здесь чаще всего и спотыкаются. С 1 марта 2021 года действуют поправки в закон о персональных данных: то, что человек сам выложил данные в открытый доступ, больше не даёт права их собирать и использовать без его согласия.
С 30 ноября 2024 года в Уголовном кодексе есть статья 272.1 о незаконном сборе, хранении и использовании персональных данных. А с 30 мая 2025 года для компаний действуют оборотные штрафы за утечки по статье 13.11 КоАП. Если парсер собирал контакты людей, а база потом утекла, отвечать придётся дважды: и за сбор, и за утечку.
Судебная практика: «ВКонтакте» против Double Data
Самое известное дело о парсинге в России (№ А40-18827/2017) шло пять лет. Стартап Double Data собирал данные из открытых профилей «ВКонтакте» и на их основе оценивал кредитоспособность заёмщиков для банков. Соцсеть посчитала это нарушением своих прав на базу данных пользователей.
Суды несколько раз меняли позицию. Первая инстанция отказала «ВКонтакте», апелляция встала на сторону соцсети, Суд по интеллектуальным правам вернул дело на пересмотр. В 2021 году Арбитражный суд Москвы снова решил в пользу Double Data: он признал, что индексирование открытых профилей не нарушает права на базу. Летом того же года апелляция это решение отменила и взыскала с компании компенсацию. В сентябре 2022 года стороны заключили мировое соглашение. Пять лет судов, а окончательного прецедента так и не появилось.
Что из этого следует на практике:
- права на базу данных у владельца сайта есть, и суды их признают;
- массовое извлечение данных, особенно о людях и для перепродажи, создаёт реальный судебный риск;
- парсинг цен и характеристик товаров к таким спорам почти не приводит.
Роль robots.txt и пользовательского соглашения
Файл robots.txt сам по себе не закон, а скорее табличка на двери для роботов. Но если сайт прямо запрещает автоматический сбор в правилах или в robots.txt, а вы его игнорируете, в споре это сыграет против вас: так проще доказать, что вы использовали сайт «ненормальным» способом и знали об этом.
Перед запуском прочитайте robots.txt и пользовательское соглашение, проверьте, есть ли официальный API, и не собирайте данные о людях без правового основания. Если проект коммерческий и масштабный, покажите его юристу. Как к парсингу относятся в других странах, мы разбирали в отдельной статье о законности веб-скрейпинга.
Почему сайты блокируют парсеры и как парсить аккуратно
Сайты не любят парсеры по двум причинам: те нагружают сервер и уносят данные конкурентам. Поэтому сайты защищаются. Обычно защита строится из нескольких механизмов:
- Лимиты запросов. Если с одного адреса приходит слишком много обращений за минуту, сервер отвечает ошибкой 429 или блокирует IP.
- Блокировки по IP. КороткоАдреса дата-центров и облачных серверов легко вычислить, и многие сайты режут их сразу.
- Капча. Она появляется, когда поведение похоже на робота: одинаковые интервалы между запросами, нет движений мыши, нет cookies.
- Цифровой отпечаток браузера (фингерпринтинг). Сайт проверяет десятки параметров браузера, от шрифтов и разрешения экрана до заголовков, и ограничивает доступ, если отпечаток выглядит неестественно. Какие из этих защит стоят на конкретном сайте, можно узнать бесплатной проверкой антибот-систем.
В старых статьях до сих пор советуют притвориться поисковым роботом Яндекса или Google. Не делайте так: крупные сайты проверяют настоящих ботов по обратному DNS-запросу, и фальшивого «Googlebot» вычисляют за секунды. А в споре такой маскарад будет выглядеть ровно тем, чем он является: обманом.
Как парсить аккуратно
- Начните с API. Если сайт отдаёт данные официально, парсинг HTML не нужен.
- Делайте паузы. Разумный темп: не больше 1 запроса в 1-3 секунды к одному сайту, ночью можно чаще. Хороший парсер сайт вообще не замечает.
- Не качайте лишнее. Кешируйте страницы, которые уже собрали, и обновляйте только то, что изменилось.
- Представляйтесь честно. Укажите в User-Agent название парсера и контакт, чтобы владелец сайта мог с вами связаться.
- Используйте прокси для распределения нагрузки. Когда объём большой, запросы распределяют между разными IP-адресами. Для сайтов со строгой защитой обычно берут резидентские или мобильные прокси: это адреса реальных провайдеров, и сайт видит обычных посетителей, а не сервер в дата-центре.
- Не нарушайте ограничения сайта. Не обходите авторизацию и платный доступ, не собирайте персональные данные без основания.
Как спарсить данные: три способа для разного уровня
Без кода: IMPORTXML в Google Таблицах
Попробовать парсинг быстрее всего в Google Таблицах: там есть встроенная функция IMPORTXML, которая забирает данные со страницы по XPath.
- Откройте нужную страницу в Chrome, кликните правой кнопкой по элементу (например, по заголовку) и выберите «Просмотреть код».
- В открывшемся коде кликните правой кнопкой по выделенной строке: «Копировать» → «Копировать XPath».
- В ячейке таблицы напишите формулу:
=IMPORTXML("https://example.com/page"; "//h1")Вместо //h1 вставьте скопированный XPath. В русскоязычной версии Таблиц аргументы разделяются точкой с запятой, в англоязычной запятой.
Так можно собрать заголовки, цены или метатеги с нескольких десятков страниц: протяните формулу вниз по списку адресов, и готово. У функции два ограничения: она не видит то, что подгружается через JavaScript, и не тянет большие объёмы.
Готовые сервисы
Если задача типовая, велосипед изобретать не нужно: готовых инструментов хватает. Когда сервис начинает упираться в блокировки, к большинству из них можно подключить прокси: например, к ParseHub или Apify.
| Инструмент | Тип | Для чего подходит |
|---|---|---|
| Screaming Frog SEO Spider | Десктопная программа | SEO-аудит сайта: метатеги, битые ссылки, дубли. Бесплатно до 500 адресов |
| Netpeak Spider | Десктопная программа | SEO-аудит и выгрузка данных со страниц по своим правилам |
| A-Parser | Десктопная программа | Парсинг выдачи, подсказок и сайтов, много готовых шаблонов |
| Octoparse, ParseHub | Конструкторы без кода | Сбор данных кликами мышью, есть бесплатные тарифы |
| Apify | Облачная платформа | Готовые парсеры для популярных площадок и запуск по расписанию |
| Сервисы мониторинга цен | Облачные сервисы | Регулярное сравнение цен с конкурентами без настройки |
На Python: минимальный парсер
Когда готовые решения не справляются, парсер пишут сами. Чаще всего для этого берут Python: у него простые библиотеки и большое сообщество. Вот рабочий пример на 15 строк, который собирает названия и цены книг с учебного сайта books.toscrape.com, созданного специально для тренировки парсинга.
import requests
from bs4 import BeautifulSoup

URL = "https://books.toscrape.com/"
headers = {"User-Agent": "my-first-parser/1.0 ([email protected])"}

response = requests.get(URL, headers=headers, timeout=10)
response.raise_for_status()

soup = BeautifulSoup(response.text, "html.parser")

for book in soup.select("article.product_pod"):
    title = book.h3.a["title"]
    price = book.select_one(".price_color").text
    print(title, price)
Чтобы запустить, установите библиотеки командой pip install requests beautifulsoup4. Дальше этот скрипт можно развивать: добавить обход всех страниц каталога, паузы между запросами и сохранение в CSV через pandas. Для сайтов на JavaScript вместо requests берут Playwright. Постраничный обход каталога, защиту от ботов и подключение прокси мы подробно разбираем в руководстве по веб-скрейпингу на Python, а настройку прокси для requests и BeautifulSoup в инструкции BeautifulSoup + прокси.
Сколько стоит парсинг
Цену определяют объём страниц, частота обновления и защита сайта. Выбор инструмента влияет меньше.
| Вариант | Из чего складывается цена | Когда выбирать |
|---|---|---|
| Своими силами без кода | Бесплатно или тариф конструктора без кода | Разовые задачи, до нескольких сотен страниц |
| Готовая программа | Лицензия или подписка (например, лицензия A-Parser стоила от 179 долларов на осень 2025 года, по данным автора vc.ru) | Регулярные типовые задачи: SEO, выдача, каталоги |
| Свой парсер | Время разработчика на создание и поддержку, серверы, прокси | Нестандартные данные и большие объёмы |
| Парсинг под ключ | Разработка, плюс абонентская плата за поддержку и выгрузки | Когда нужны данные, а не инструмент |
Отдельно заложите бюджет на поддержку. Сайты меняют вёрстку, и парсер, который ещё вчера работал, а сегодня уже возвращает пустую таблицу.
Подведем итоги
Парсинг давно перестал быть хакерской магией. Это обычный рабочий инструмент, как Excel или CRM: он выгружает с сайтов то, что вы и так могли бы увидеть глазами, только делает это быстро и без перерывов на обед.
Если вы только присматриваетесь, начните с малого. Возьмите одну задачу, которая уже отнимает у вас время, например сверку цен с парой конкурентов. Проверьте, нет ли у сайта API. Если нет, попробуйте IMPORTXML на десятке страниц. Когда формулы станет мало, переходите к готовому сервису или короткому скрипту на Python.
Пока объёмы небольшие, хватит пауз между запросами и честного User-Agent. Когда страниц становятся тысячи и сайты начинают отвечать капчей, подключайте прокси для парсинга: запросы распределяются между разными IP-адресами, и сайт видит обычных посетителей, а не один сервер.
И держите в голове, что цены, товары и открытая статистика обычно безопасны. Персональные данные и всё, что спрятано за авторизацией, без юриста лучше не трогать.
Источники
- «Индексирование и кэширование не нарушает смежные права соцсети на базу данных пользователей», «Адвокатская газета», 31.03.2021
- «СИП утвердил мировое соглашение между «ВКонтакте» и Double Data», Право.ру, 21.09.2022
- Статья 272.1 УК РФ, обзор изменений, ppt.ru
- Оборотные штрафы за утечки персональных данных с 30 мая 2025 года, Habr