
2026 年 14 个用于网页抓取的开源 GitHub 仓库


十四个开源 网页抓取工具 你可以克隆下来,在自己的基础设施上运行,无需额度,也没有按页计费。我们于 2026 年 8 月 19 日从 GitHub 抓取了星标数、许可证和提交日期,随后通读了每一份 README,以核实这些项目确实如其所述。
本文面向已经了解无头浏览器是什么的开发者。如果你其实是在托管平台之间做选择,我们的 AI 网页抓取技术栈解析 涵盖了这些内容。
先说明一点,因为它决定了本文写什么、不写什么。这里的一切都假定你所采集的是公开可获取的数据,并且符合法律以及目标网站的服务条款。这是一条实实在在的约束,而非套话。它排除了这些工具在技术上能做到的一部分事情,我们也标注了这条界线所在的位置。
披露: NodeMaven 赞助开源抓取项目,下文中的每个仓库都在其 README 中带有 NodeMaven 板块。正因如此我们对这些项目非常熟悉,但这并不是它们出现在这里的原因。入选标准是采用度、维护活跃度,以及一个项目是否能做到其他项目做不到的事。无论由谁赞助,Scrapling、MediaCrawler 和 Camoufox 都会稳居任何一份诚实榜单的前列。
简而言之
如果你使用 Python 语言 编写代码,并且希望有一个工具能覆盖大部分工作,那就选 Scrapling。如果现有的 Playwright 项目开始失效,Patchright 只需改一行即可。如果输出要送入 LLM,就用 webclaw。如果你需要的是整个团队共同指向的基础设施,而不是每个项目各自引入的库,那就看看 HeadlessX 或 trawl。
无论你选择哪一个,你仍然需要代理。这些项目负责解析、渲染和指纹伪装,但没有一个能控制你的请求来自哪个 IP,而这恰恰是大多数反爬系统最先检查的东西。
我们如何筛选这些仓库
持续维护中。 下面每个仓库在过去六周内都有提交记录。一个在 2025 年就停止更新的隐身库比没有还糟糕,因为反爬厂商的迭代速度远快于此。
解决具体问题。 这里的五个项目都能减少浏览器自动化中被拦截的请求,而它们采用的是五种不同的方式。我们把五个都保留了下来,因为哪个更合适取决于你是从零开始,还是在为现有技术栈打补丁。
真实的采用度,只有一个刻意的例外。 Star 数量如实呈现,而不是假装一个新项目已经拥有它尚未赢得的社区。
文中所有安装命令均取自各项目截至 2026 年 8 月 19 日的 README。由于打包方式会发生变化,运行前请先查看仓库。
按类别和技术栈划分的全部仓库
| 仓库 | 类别 | 技术栈 | Star 数 | 许可证 | 需要代理 |
|---|---|---|---|---|---|
| Scrapling | 框架 | Python 语言 | 75,066 | BSD-3-Clause | 是,轮换代理 |
| MediaCrawler | 垂直领域爬虫 | Python + Playwright | 62,928 | 查看代码仓库 | 是,粘性会话 |
| Obscura | 无头浏览器引擎 | Rust + V8 | 21,653 | Apache-2.0 | 是 |
| Camoufox | 防检测浏览器 | C++ / Python | 11,227 | MPL-2.0 | 是 |
| pydoll | 浏览器自动化 | Python (CDP) | 7,029 | MIT | 是 |
| google-maps-scraper | 垂直领域爬虫 | Go | 5,554 | MIT | 是,需地理定位 |
| webclaw | LLM 提取 | Rust | 2,281 | AGPL-3.0 | 视情况而定 |
| HeadlessX | 自托管平台 | TypeScript | 2,246 | 查看代码仓库 | 是 |
| Patchright | 自动化 | Python 语言 | 1,469 | Apache-2.0 | 是 |
| Botright | 自动化 + CAPTCHA | Python + Playwright | 1,012 | GPL-3.0 | 是 |
| trawl | 验证挑战破解器 | Bun + Elysia | 698 | AGPL-3.0 | 第 4 档内置 |
| GoScrapy | 框架 | Go | 363 | 查看代码仓库 | 是,轮换代理 |
| AutomatiQ | 脚本生成 | Python + CDP | 165 | MIT | At runtime |
| scrapy-stealth | Scrapy 插件 | Python 语言 | 2 | 查看代码仓库 | 支持,内置轮换 |
Star 数与提交日期已于 2026 年 8 月 19 日在 GitHub 上核实。授权协议来自各代码仓库自身的元数据。有四个项目没有以机器可读的形式声明授权协议,因此在商用前请自行确认。
反检测浏览器与自动化
五个项目,同一个目标:减少浏览器驱动采集中的请求失败与速率限制。它们的区别在于 其中 规范化浏览器指纹的方式,而这决定了各自方案的可靠程度。
1. Camoufox, 11,227 ⭐
大多数隐身工具通过注入 JavaScript 来改写 navigator.webdriver 之类的属性。但注入本身就是一种信号,因为反机器人脚本会检查这些属性是否被篡改过。Camoufox 走了另一条路:它在一个修改版 Firefox 构建中,于 C++ 和 Juggler 引擎层面对指纹打补丁,因此从 JavaScript 的视角看根本无迹可寻。它是这一组中最成熟的项目,也是衡量其他项目的参照标准。
不过你用的是 Firefox。如果目标站点在 Chrome 中的渲染方式不同,或者你的工具链默认基于 Chromium,那么这种摩擦你很早就会感受到。
pip install cloverlabs-camoufox最适合: 在全新起步的项目中应对高难度目标。
2. Patchright, 1,469 ⭐
它的定位异常聚焦,这正是它奏效的原因。标准的 Playwright 会泄露 Chrome DevTools Protocol 的痕迹,Cloudflare 这一级别的系统能够稳定识别出来。Patchright 移除了这些痕迹,其他一概不改。你只需替换一处 import。没有新的 API,没有新的浏览器,也不用重写选择器。
它修补的是自动化层而非浏览器引擎,因此面对最严苛的目标时,Camoufox 的处理更为深入。但在大多数场景下,这样的取舍完全可以接受。
pip install patchright最适合: 最近开始遭到封锁的现有 Playwright 项目。这是本列表中投入最小的解决方案。
3. pydoll, 7,029 ⭐
pydoll 通过 WebSocket 以 CDP 直接与 Chrome 通信。这里没有 WebDriver 二进制文件,也没有 navigator.webdriver 标志,因为整个技术栈中根本不存在 WebDriver。
它值得单独占据一席之地的原因在于,它针对的是行为检测,而不只是指纹。鼠标移动遵循贝塞尔曲线,键入具有真实的节奏,滚动带有物理效果。README 中有一点值得再强调一遍:指纹的强度取决于最薄弱的那一层,因为反机器人系统会跨所有层面关联信号。再完美的 user agent,配上机械式的鼠标移动,照样会失败。
pip install pydoll-python最适合: 会对交互模式而不仅仅是请求头进行评分的目标。
4. Botright, 1,012 ⭐
本节中的其他工具都把验证码问题留给了你。Botright 将验证码破解与指纹处理一同打包进同一个基于 Playwright 的软件包,从而省去了技术栈中的一项第三方集成。
有两点需要了解。它与 Patchright 出自同一位作者,并且仍在积极维护:最后一次提交是 2026 年 8 月 18 日,这纠正了一个相当常见的误解,即该项目已经停止更新。此外,它采用 GPL-3.0 协议,是这里最严格的授权协议,对商业产品有实际影响。在基于它进行开发之前,请参阅 授权协议章节 再基于它进行开发。
pip install botright

playwright install
最适合: 验证码是主要瓶颈且可以接受 GPL 协议的工作流。
5. Obscura, 21,653 ⭐
一款用 Rust 基于 V8 编写的无头浏览器引擎,定位是替代无头 Chrome。根据其 README,每个实例约占用 30 MB 内存,而无头 Chrome 需要 200 MB 或更多,并且启动几乎是瞬时的。它支持 CDP,因此 Puppeteer 和 Playwright 客户端无需修改即可连接。
在大规模场景下,这个内存数字就是全部理由所在。它决定了一台机器上能跑十个并发浏览器还是一百个。需要注意的是,它是一款年轻的引擎,而非 Chromium,因此在复杂网站上难免会遇到边缘情况。请用你最棘手的页面去测试,而不是用演示页面。
docker run -d --name obscura -p 127.0.0.1:9222:9222 h4ckf0r0day/obscura

Building from source with stealth enabled:

git clone https://github.com/h4ckf0r0day/obscura.git

cd obscura

cargo build --release -p obscura-cli --bins --features render,stealth
最适合: 以浏览器内存为瓶颈的高并发抓取任务。
抓取框架
6. Scrapling, 75,066 ⭐
按 star 数计算,Scrapling 是本列表中采用度遥遥领先的项目,而且差距还在不断拉大。原因在于自愈式选择器。当网站重命名某个 CSS 类或移动某个元素时,解析器会重新定位它,而不是在凌晨两点返回 None。
这正是那些托管平台按页面收取 LLM 费用所提供的能力,只不过这里是一个本地解析器,完全不需要调用 API。其抓取器还能应对 Cloudflare 级别的防护,因此一个库就覆盖了这项工作的两个方面。
pip install "scrapling[fetchers]"

scrapling install

Optional extras for AI-assisted extraction and the interactive shell:

pip install "scrapling[ai]"

pip install "scrapling[shell]"
最适合: 几乎任何 Python 抓取项目。如果你只从这份列表中选一个仓库,就选它。
7. GoScrapy, 363 ⭐
大多数 Go 语言抓取代码都是基于 colly 或原生 net/http 从零写起的,当项目规模超出最初设计时,这一点就暴露无遗。GoScrapy 保留了 Scrapy 用户已经熟悉的 spiders、middlewares 和 pipelines 架构,因此从 Python 转向 Go 的团队不必重新设计整个项目结构。需求虽窄,但确实长期无人满足。
go install github.com/tech-engine/goscrapy/cmd/...@latest最适合: 希望获得结构化架构的 Go 团队,以及为提升吞吐量而迁移的 Python 团队。
8. scrapy-stealth, 2 ⭐
实话实说:只有两个 star,目前还没有社区。
它之所以入选,是因为它填补了一项无人覆盖的空白。它是唯一一个专为 Scrapy 打造且仍在积极维护的隐身层,而大量运行在生产环境中的 Scrapy 项目正悄然被现代防护机制甩在后面,除了重写别无升级路径。该插件在无需改动现有 spiders 的前提下,加入了浏览器模拟、代理轮换、指纹轮换和重试逻辑。我们查看时,当天就有一次提交。
pip install scrapy-stealth最适合: 你不想推倒重来的现有 Scrapy 代码库。请锁定版本并阅读源码。在这样的采用度下,你是早期用户,而不是客户。

如果你正在搭建其中某套方案,我们的住宅 IP 在进入 IP 池之前都会经过质量筛选,这正是在那些真正设有防护的目标站点上保持高成功率的关键。 以 3.50 美元试用起步 并在做出任何决定之前,用你自己最棘手的页面进行测试。
面向 LLM 与 RAG 流程的内容提取
9. webclaw, 2,281 ⭐
webclaw 能将网页转换为干净的 Markdown、JSON 或可直接供 LLM 使用的上下文,是最接近 Firecrawl 的开源替代方案。它的独特之处在于提供了你想要的各种形态:CLI、MCP 服务器、REST API,以及面向 Node、Python 和 Go 的 SDK。其中 MCP 服务器的意义比听起来更重要,因为 AI 编程智能体可以直接把它当作工具调用,无需再编写封装层。
代理支持是原生一等公民,而不是事后拼接上去的。WEBCLAW_PROXY 接受单个端点,WEBCLAW_PROXY_FILE 则接受一个代理池。
它采用 AGPL-3.0 许可。如果你要把它嵌入到托管的商业产品中,请先阅读 授权协议章节 首先。
brew tap 0xMassi/webclaw

brew install webclaw

通过 Docker 一次性运行:

docker run --rm ghcr.io/0xmassi/webclaw https://example.com

SDK:

npm install @webclaw/sdk

pip install webclaw

go get github.com/0xMassi/webclaw-go
最适合: 适用于 RAG 数据摄取以及需要从任意 URL 获取干净文本、又不想被额度计费的 AI 代理(agent)。
自托管基础设施
这些是整个团队共同指向的服务,而不是每个项目各自引入的库。正因为这一区别,它们才被单独归为一节。
10. HeadlessX, 2,246 ⭐
本质上就是内置了反检测能力的 Browserless,基于 Camoufox 运行。你只需搭建一个端点,所有人都把自动化任务提交到这里,排队、日志、API 密钥和代理管理都由它集中处理。
最后这一点的价值兑现得比预期更快。代理凭据散落在十几位开发者的 .env 文件里,正是它们最终被提交到公开仓库的原因。
由于它构建在 Camoufox 之上,也就继承了同样的检测特征。如果目标站点已经学会识别 Camoufox,HeadlessX 也救不了你。
npm install -g @headlessx-cli/core

headlessx init

headlessx status

headlessx doctor
最适合: 适合希望共享浏览器基础设施、而不是每个人各自运行一套的团队。
11. trawl, 698 ⭐
trawl 代替你的其他工具解决 JavaScript 质询,可作为 FlareSolverr 的直接替代品。其 README 称它的运行速度快 2 到 6 倍,并通过 Redis 会话缓存在大约 500ms 内返回重复请求。
精妙之处在于四级递进机制。请求先以普通 HTTP 抓取发起;被拦截后,改用缓存的浏览器会话重试;仍被拦截,则重新解算质询;只有到了第四级,才会通过住宅代理路由。在大多数页面并无防护的大规模抓取中,这意味着你只在真正需要的请求上支付昂贵的带宽费用。
git clone https://github.com/germondai/trawl

cd trawl

cp .env.example .env

docker compose up -d
采用 AGPL-3.0 许可,且基于 Camoufox,因此 HeadlessX 那条关于继承指纹的提醒在这里同样适用。
最适合: 适合混合型工作负载:部分目标有防护,而大多数没有。
现成的垂直领域抓取工具
有时目标本身就是一个知名平台,根本没有必要自己再造轮子。
12. MediaCrawler, 62,928 ⭐
一款面向中国社交媒体的多平台采集器,覆盖小红书、抖音、快手、哔哩哔哩、微博、贴吧和知乎。它是本榜单上星标数第二多的项目,这也说明此类数据在别处有多么缺乏支持。
从架构上看,它的有趣之处在于它拒绝做什么。它没有去逆向工程各平台的请求签名算法(那种方式会不断失效,并演变成一份全职维护工作),而是直接驱动浏览器上下文。单次请求更慢,但耐用得多。
使用这一款之前,请先阅读相关条款。 其中若干平台在服务条款中限制自动化采集,而 MediaCrawler 所能实现的部分操作已超出这些条款允许的范围。在平台明示规则之内采集公开数据没有问题;绕过访问控制则不然,我们也不会为此提供协助。
uv run uvicorn api.main:app --port 8080 --reload

cd webui && npm install && npm run dev
最适合: 适合在各平台规则允许范围内,对中国平台开展研究和市场情报分析。
13. google-maps-scraper, 5,554 ⭐
从 Google Maps 抓取商户列表数据:名称、电话号码、网站、评论数、评分和坐标。它同时提供 CLI、Web 界面和 REST API,还附带一个 Agent Skill,让 AI 代理(agent)能够端到端地运行整个工作流。最后这一点并不常见,如果你正在搭建智能体流水线会很有用。
mkdir -p gmaps-output

docker run \

  -v gmaps-playwright-cache:/opt \

  -v "$PWD/example-queries.txt:/queries.txt:ro" \

  -v "$PWD/gmaps-output:/out" \

  gosom/google-maps-scraper \

  -input /queries.txt

在 8080 端口启用 Web UI:

docker run -v "$PWD/gmapsdata:/gmapsdata" -p 8080:8080 \

  gosom/google-maps-scraper -data-folder /gmapsdata
地图结果天然依赖地理位置,因此定位准确与否是正确性要求,而不是可有可无的优化。用法兰克福数据中心 IP 搜索“dentists in Chicago”确实会返回结果,只是和芝加哥本地用户看到的内容不一样。
最适合: 本地市场调研与基于位置的获客工作。
自动化与脚本生成
14. AutomatiQ, 165 ⭐
AutomatiQ 会观察你使用某个网站的过程,然后把整个会话逆向还原成一个独立的 Python 脚本。它记录网络流量和交互行为,由视觉模型为每一步操作添加注释,再由智能体在沙箱中反复迭代,直到生成的脚本能够对真实数据正常运行。
生成的脚本无需浏览器即可运行。你拿到的是底层请求,而不是一次 Playwright 回放,这就是每页 2 MB 的脚本和每页 50 KB 的脚本之间的差别。在需要反复执行的任务上,这个差距会迅速累积放大。
它仍处于 alpha 阶段,165 个 star。请把它的输出当作一份优秀的初稿,而不是可直接上线的生产代码。
pip install automatiq

从源码安装:

git clone https://github.com/StoneSteel27/AutomatiQ.git

cd AutomatiQ

uv sync

uv run automatiq run https://example.com
最适合: 搞清楚一个网站的公开 API 实际上是如何工作的。
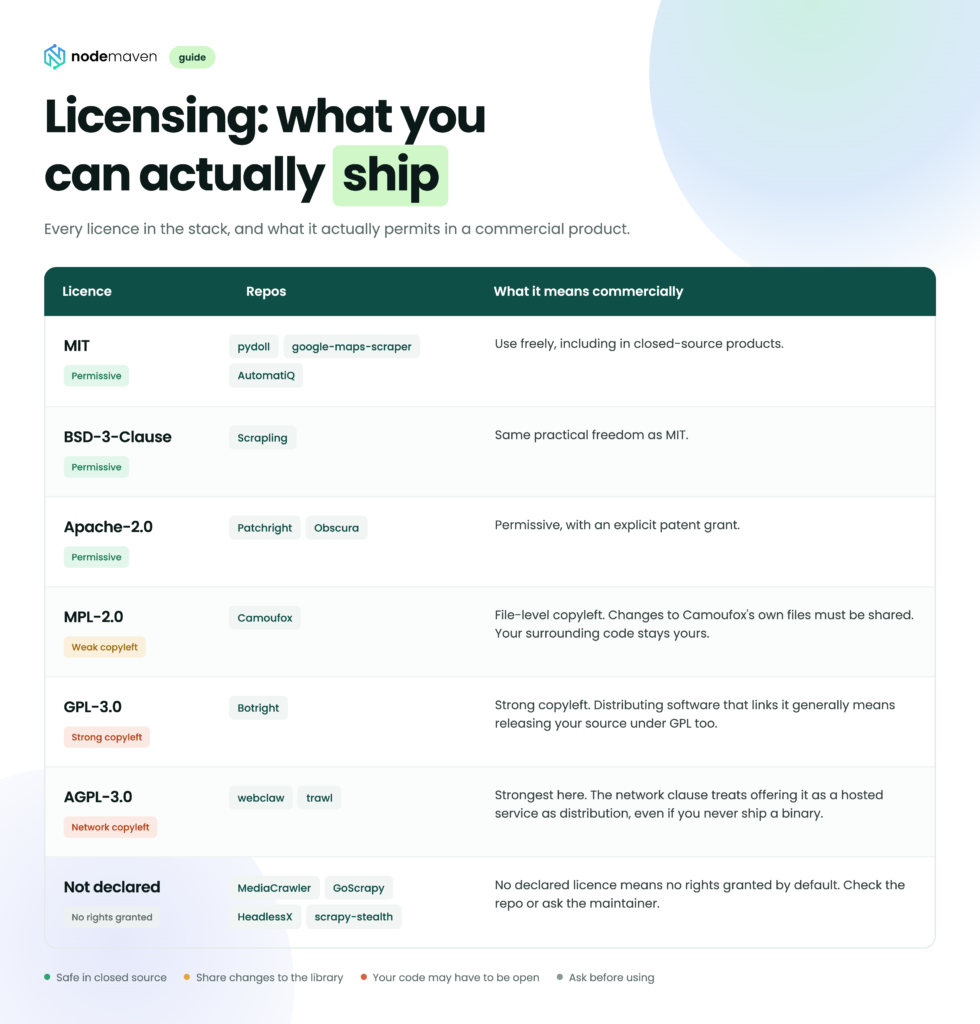
关于许可证你需要了解的内容
如果你只是在内部运行这些工具,这些都无关紧要。但如果客户要付费使用你在其之上构建的东西,那么 webclaw 和 trawl 所采用的 AGPL 就是你必须仔细审视的红线,而“我们只在自己的服务器上运行”恰恰正是 AGPL 所要覆盖的情形。
以上不构成法律意见,且授权文件会发生变动。在基于它开发之前,请自行查阅仓库。
这些工具在哪些场景需要代理
这里的每个项目都在处理解析、渲染和指纹规范化的某种组合。但它们都无法控制请求来自哪个 IP,而这恰恰是反爬系统成本最低的一项检查,因此通常也是最先执行的一项。一个配置再完善的浏览器,只要来自被标记的数据中心 IP,往往在指纹被检查之前就已经遭到拒绝。
| 仓库 | 需要代理 | 类型 | 为什么 |
|---|---|---|---|
| Camoufox, Patchright, pydoll, Botright | 是 | 住宅代理 | 指纹的问题解决了,IP 的问题没有。 |
| Obscura | 是 | 住宅代理 | 高并发意味着来自同一来源的请求量非常大。 |
| Scrapling, GoScrapy, scrapy-stealth | 是 | 轮换住宅代理 | 框架级的请求量很快就会触发速率限制。 |
| webclaw | 视情况而定 | 住宅代理 | 原生支持 WEBCLAW_PROXY。抓取公开 URL 时可能用不上。 |
| HeadlessX | 是 | 住宅代理 | 内置集中式代理管理,直接用即可。 |
| trawl | Built in | 住宅代理 | 升级模型的第四层 is 住宅代理。 |
| MediaCrawler | 是 | 移动代理,粘性 | 基于会话的采集需要在整个会话期间保持稳定的身份。 |
| google-maps-scraper | 是 | 住宅代理,城市级定位 | 结果取决于地理位置,因此位置的准确性就是数据的准确性。 |
| AutomatiQ | At runtime | 住宅代理 | 生成的脚本直接调用接口,前端没有浏览器。 |
有两点值得牢记于心。
轮换代理和粘性代理是两种不同的工作。 抓取 50,000 个商品页面时,希望每个请求都用一个全新的 IP。而基于会话的工作流则需要在整个过程中保持同一个 IP。两者用错场合,正是有些人断定代理“不好用”的原因,其实只是把工具用在了错误的任务上。 静态ISP代理 介于两者之间,适合任何既需要固定身份又需要速度的场景。
你付费购买的是流量,而不是请求次数。 一个由浏览器渲染、包含图片和 CSS 的页面通常有 1 到 3 MB。而从底层 JSON 接口获取同样的数据只有大约 50 KB。同样的输出,成本却相差 20 到 60 倍,这也正是 AutomatiQ 那种“找到接口”的思路在任何重复性任务上都值得投入的原因。我们的 Python 抓取指南 讲解了如何在 DevTools 中找到这些接口。
在确定购买用量之前,先测算你的页面实际消耗多少流量。 带宽检测工具 只需几分钟即可完成,而且完全免费。


