
LinkedIn 数据采集:方法、挑战与最佳实践


拥有超过 10亿用户 在全球范围内,LinkedIn 是企业、招聘人员和研究人员收集专业数据最有价值的平台之一。然而,手动提取 LinkedIn 数据既耗时又低效,这也是许多人转而采用 LinkedIn 抓取作为解决方案的原因。
LinkedIn 抓取让企业能够高效地收集结构化数据,但它也伴随着挑战,包括严格的反机器人系统和法律方面的考量。
在本文中,我们将探讨LinkedIn抓取的工作原理、它带来的挑战、最佳实践,以及使用代理如何帮助你确保数据采集顺利进行。
什么是LinkedIn抓取?
LinkedIn 抓取是指 自动提取公开数据 来自 LinkedIn 个人资料、招聘信息和公司主页。
网页抓取工具无需手动浏览和复制信息,而是自动化这一过程,使其 更快、更具可扩展性且更高效。
企业和研究人员为何使用 LinkedIn 数据抓取
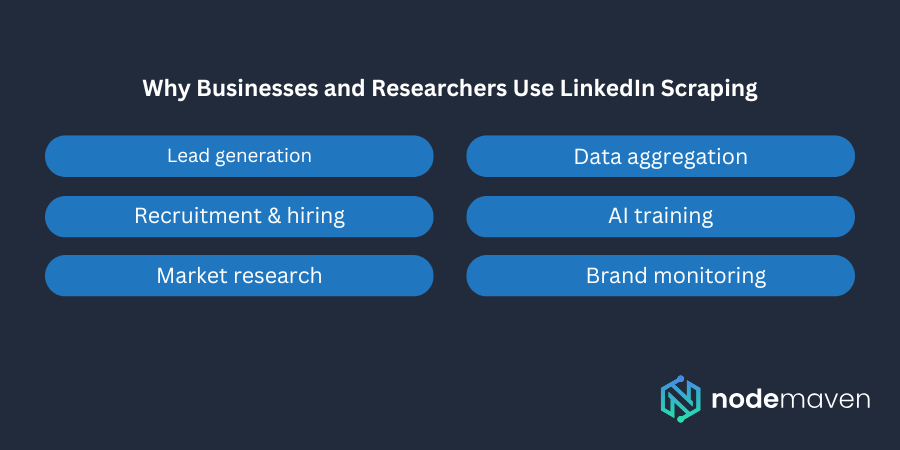
企业和研究人员出于多种原因利用 LinkedIn 抓取,例如:
- 潜在客户开发: 销售和营销团队从潜在客户处提取联系方式,以开展外联营销活动。
- 招聘与人才引进: HR 专业人员抓取 LinkedIn,以根据特定技能、职位头衔和经验寻找求职候选人。
- 市场调研: 企业借此收集行业洞察、竞争对手分析和招聘趋势。
- 数据聚合与 AI 训练: 研究人员使用 LinkedIn 数据来训练用于就业市场预测或自动化工具的机器学习模型。
- 品牌监测: 企业会追踪竞争对手如何与员工和客户互动。
虽然 LinkedIn 数据抓取能够提供强大的商业洞察, 必须谨慎操作,以避免账户限制和法律问题。
LinkedIn 抓取的工作原理
抓取 LinkedIn 涉及 向 LinkedIn 的服务器发送自动化请求 来检索并结构化数据。
然而,LinkedIn 采用了严格的 反抓取措施,因此有必要使用 先进的抓取技术与代理解决方案。
提取 LinkedIn 数据的常用技术
LinkedIn 抓取有多种方法,每种方法各有优势和风险:
- 手动数据提取: 手动复制粘贴数据,速度慢且效率低,不适合大规模数据采集。
- 网络爬虫 机器人和自动化工具: 基于 Python 的抓取框架,例如 Selenium、Puppeteer 和 Scrapy 使数据提取过程自动化。
- API 访问(受限且收费): LinkedIn 提供了 LinkedIn API,但对大多数用户而言,访问受到限制且成本高昂。
- 第三方抓取工具: 一些 SaaS 工具可以自动提取 LinkedIn 数据,尽管它们可能违反 LinkedIn 的条款。
代理在 LinkedIn 抓取中的作用
使用 代理 对于成功抓取 LinkedIn 至关重要。LinkedIn 会主动监控并 会拦截重复的抓取请求,会将来自同一 IP 的可疑活动标记出来。
代理的帮助方式包括:
- 隐藏你的真实 IP 地址:防止 LinkedIn 识别出你的抓取行为。
- 轮换 IP 以避免速率限制:降低被检测或被封锁的风险。
- 启用地理定位:不受限制地从不同国家访问LinkedIn。
- 创建匿名性:在自动化数据收集的同时保护你的身份。
无需 高级代理,抓取 LinkedIn 的尝试很可能因检测和封锁机制而失败。
抓取 LinkedIn 的挑战
在各大社交媒体平台中,LinkedIn拥有最严格的反抓取机制之一。
与其他网站不同,LinkedIn 积极投入于 反机器人检测、AI 驱动的行为追踪,以及频繁的安全更新 以防止自动化数据提取。
这使得抓取 LinkedIn 比抓取 Twitter 或招聘网站等开放网站要困难得多。
以下是用户在尝试时面临的主要挑战 LinkedIn 数据抓取:
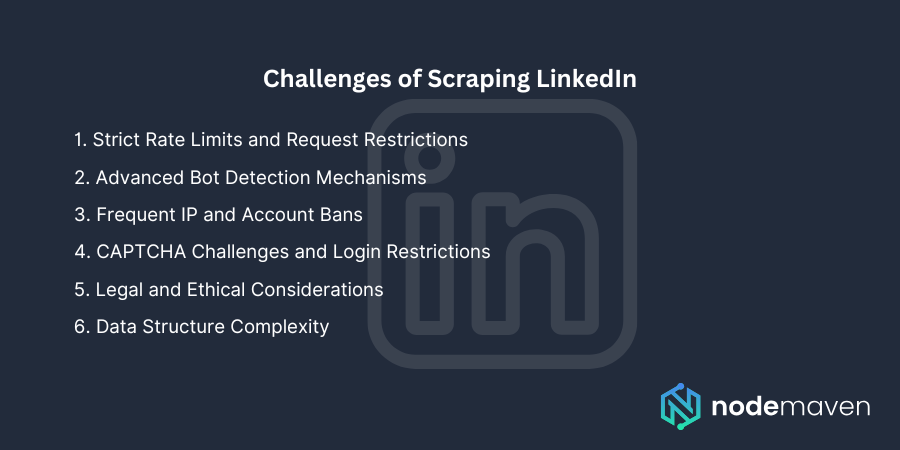
1. 严格的速率限制和请求限制
LinkedIn 会监测来自单个 IP 或账户的请求数量。如果在短时间内发送过多请求,LinkedIn 将该活动标记为可疑 并可能会暂时限制访问或实施 IP 封禁。
示例: 如果抓取工具使用同一个IP在几分钟内提取数千个LinkedIn个人资料,LinkedIn就会识别出这种异常活动并阻止进一步访问。
解决方案: 使用 轮换住宅代理 能够动态切换 IP,模拟真实的人类用户。
2. 先进的机器人检测机制
LinkedIn的安全系统 追踪浏览器指纹、鼠标移动、滚动行为和击键模式 以区分真人用户和机器人。
示例: 一个在 LinkedIn 页面上导航过快、没有自然鼠标移动的机器人,很可能会被标记。
解决方案: 使用 具备拟人化交互模拟的无头浏览器 (随机的滚动速度、逼真的鼠标移动以及自然的按键节奏)。
3. 频繁的 IP 和账户封禁
与过度活动相关联或被标记为代理的 IP 地址可能会被永久禁止访问 LinkedIn。此外,LinkedIn 还可能强制实施 账号封禁,尤其是当抓取工具在抓取时登录了某个个人资料的情况下。
示例: 使用自动化工具抓取成千上万名求职候选人的招聘人员,可能会发现自己的 LinkedIn 账户突然被限制。
解决方案: 抓取时避免登录账户,并依靠 高质量代理 ,配合庞大的 IP 池以防止被检测。
4. CAPTCHA 验证和登录限制
LinkedIn 经常会弹出 CAPTCHA 或登录验证 当检测到异常活动时,会大大加大自动化抓取的难度。
示例: 在抓取几百个个人资料后,LinkedIn可能会强制要求进行CAPTCHA测试或发送电子邮件验证请求。
解决方案: 使用 借助黏性住宅代理进行会话控制 以更长时间保持相同的 IP,减少登录验证的次数。
5. 法律与道德考量
数据采集 公开可用的数据 通常是被允许的,但 LinkedIn 的服务条款禁止 未经授权的数据提取。 抓取非公开数据或将抓取的数据用于商业目的时,会引发法律方面的挑战。
示例: LinkedIn 起诉了一家名为 hiQ Labs 抓取用户个人资料,从而引发了一场旷日持久的法律纠纷。
解决方案: 专注于抓取公开可用的数据,并确保遵守诸如以下的数据保护法律 GDPR 与 CCPA。
6. 数据结构复杂性
与简单的网站不同,LinkedIn 的 HTML 结构经常变化,使抓取程序更难提取到一致的数据。
该平台还使用 动态加载,这意味着内容只有在用户向下滚动时才会显示,从而降低了传统抓取工具的效果。
示例: 如果抓取工具不模拟滚动行为,抓取职位列表可能会失败。
解决方案: 使用 Selenium 或 Puppeteer 以与动态加载的内容进行交互。
要成功应对这些挑战,需要 最佳实践 以及合适的 代理设置 以避免被检测。
LinkedIn 抓取的最佳实践
要高效且安全地抓取LinkedIn,请遵循以下最佳实践:
- 使用轮换住宅代理:与其从同一个 IP 发送所有请求,不如轮换 IP 地址以模拟真实用户并防止被检测。
- 限制请求频率:避免激进的抓取模式;将请求分散在一段时间内,以避免引起 LinkedIn 的注意。
- 模拟人类行为:添加 随机延迟、鼠标移动和滚动 让交互看起来更自然。
- 仅抓取公开数据:避免尝试提取私密或非公开的 LinkedIn 信息。
- 使用无头浏览器和用户代理:模拟真实浏览器,通过 随机化 user-agent 字符串 以及浏览器指纹识别。
- 避免使用免费或低质量的代理:廉价或免费的代理往往已被列入黑名单,无法用于抓取 LinkedIn。
遵循这些准则, 企业即可采集 LinkedIn 数据,而不会被封锁或违反服务条款。
借助 NodeMaven 的代理提升 LinkedIn 抓取效果
使用 优质代理 是实现以下目标的最佳方式 在规避封禁的同时扩大 LinkedIn 抓取规模.
NodeMaven 提供优质 住宅代理 专为不间断的 LinkedIn 数据提取而定制。
以下是 NodeMaven 成为抓取 LinkedIn 终极解决方案的原因:
- 轮换住宅代理 实现无法被检测的抓取:在数百万个真实住宅 IP 之间轮换,以规避 LinkedIn 的反抓取防御机制。
- Geo-targeted IPs:不受限制地从全球特定地区抓取 LinkedIn 数据。
- 高速、低延迟的连接:确保数据提取顺畅进行、不被中断。
- 静态住宅代理 用于持久会话:在需要时更长时间地保持同一个 IP。
- 会话控制与 IP 粘性:保持会话持久性,以减少频繁登录。
- 全天候支持与专家协助:随时获得优化LinkedIn抓取策略的帮助。
借助 NodeMaven 的高级 用于LinkedIn的代理,抓取 LinkedIn 是 更快、更安全、更有效。
轻松解锁 LinkedIn 数据——爬虫浏览器 + NodeMaven 代理确保可靠性和匿名性。
准备好像专业人士一样抓取 LinkedIn 了吗?立即注册 NodeMaven,让你的 LinkedIn 数据提取更上一层楼! 🚀


