
ChatGPT 网页爬取:轻松构建 Python 爬虫的方法


我想看看 ChatGPT 在 网络爬虫。我决定用一个简单的任务来试一试:拿一个公开的产品页面,提取标题、价格、评分和库存情况,并将结果保存到 CSV 中。
总而言之,ChatGPT 能帮上很大的忙,但它本身并不是一套完整的抓取方案。
如果 ChatGPT 具备网络访问能力,它可以小规模地从页面中提取或总结信息。但如果你想要可重复的网页抓取、结构化数据、多个 URL、JavaScript 渲染、重试机制以及更少的拦截,那么你仍然需要代码和基础设施,其中包括 代理.
对我来说,最终好用的配置是:
- 用 ChatGPT 编写和修复爬虫
- 用于运行抓取工具的 Python
- 当页面使用 JavaScript 时使用 Playwright
- 当请求开始被拦截或变得对地区敏感时使用代理
ChatGPT 能抓取网站吗?
可以,但仅限于有限的方式。 ChatGPT 在具备联网功能时可以处理网络信息。如果你需要快速查询、简短摘要或少量手动核对,这很有用。但这与可扩展的网页抓取并不是一回事。
如果你需要跨多个页面抓取产品价格、评论、商品列表、搜索结果或市场数据,你就需要一个用以下语言编写的抓取工具: Python 语言、JavaScript 或另一种编程语言。
ChatGPT 最适合用作帮助你构建爬虫的助手。
它可以:
- 编写第一版代码
- 说明应该使用哪些选择器
- 修复 Python 错误
- 为 Playwright 重写抓取器
- 添加 CSV 或 JSON 导出功能
- 添加代理
- 添加重试和封锁检测
OpenAI 的网页搜索工具旨在检索带引用的最新信息,而不是运行结构化的抓取流程。
如何用 ChatGPT 进行抓取
第 1 步:选择要抓取的页面
选择一个简单的页面来构建和测试你的抓取器。测试时,我使用的是:
https://books.toscrape.com/
Books to Scrape 是一个用于练习网页抓取的沙盒网站。
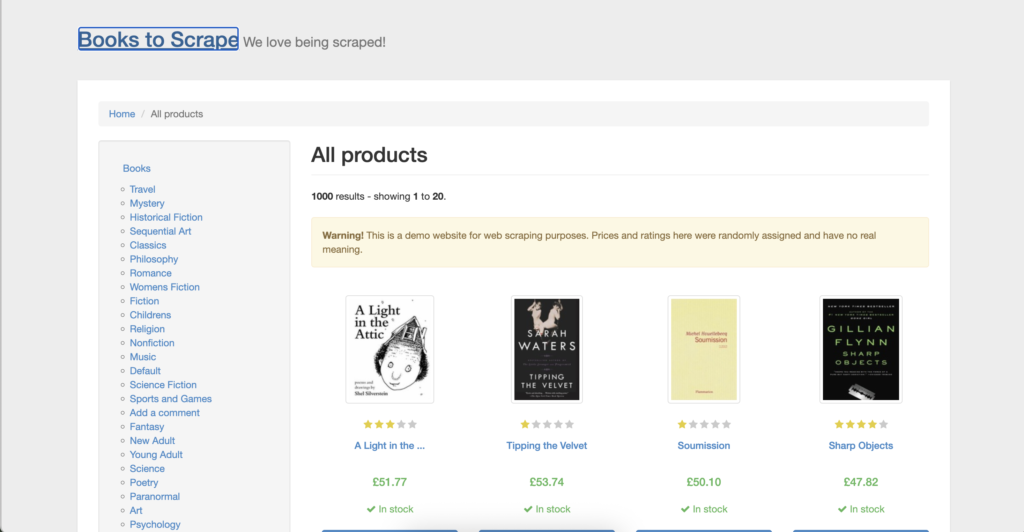
我让任务保持简单。我希望最终得到一个 CSV 文件,其中包含:
- 书名
- 价格
- 可用性
- 产品链接
第 2 步:复制产品选择器
在向 ChatGPT 索要代码之前,我先在 Chrome 中打开了 Books to Scrape,并检查了其中一张图书卡片。
我右键点击一个书名,点击“检查”,查看了标题、价格、库存情况和产品链接周围的 HTML。然后我复制了选择器,这样 ChatGPT 就不必猜测页面结构了。
这个过程很简单:
- 右键点击书名,然后点击 Inspect
- 右键点击高亮的 HTML 元素
- 选择“复制”→“复制选择器”
- 对价格和库存情况重复相同操作
- 对于商品链接,请检查书名或图片链接
第 3 步:提示 ChatGPT 构建抓取程序
然后我把页面 URL、我想要的字段以及我复制的选择器交给了 ChatGPT。
提示词大致是这样的:
我想从这个演示网站抓取公开的产品数据:
https://books.toscrape.com/

我需要一个包含以下内容的 CSV 文件:
- 书名
- 价格
- 可用性
- 产品链接

以下是我从 Chrome DevTools 复制的选择器:
图书卡片选择器:article.product_pod
书名选择器:h3 a
价格选择器:.price_color
可用性选择器:.availability
商品链接选择器:h3 a

编写一个 Python 抓取器,从第一页提取所有书籍,并将结果保存到 books_to_scrape_products.csv。

Use requests and BeautifulSoup.
为缺失的标题、价格、库存或链接添加简单的错误处理。
将相对产品链接转换为完整的 URL。
你需要一个详细的提示词,而不仅仅是“抓取这个网站”。ChatGPT 知道了页面、字段、输出格式以及我想要的确切结果。
第 4 步:从 BeautifulSoup 开始
Books to Scrape 是一个静态演示网站,所以第一个版本我并不需要 Playwright。
这让整个设置变得更简单。
抓取流程如下:
- 打开 Books to Scrape 首页
- 找到每一个产品卡片
- 提取标题、价格、库存情况和链接
- 把相对链接转换成完整的 URL
- 把所有内容保存到一个 CSV 文件中
ChatGPT 首先生成了一个 BeautifulSoup 版本,对这个页面来说是合理的。
如果我抓取的页面是用 JavaScript 加载商品的,我会让 ChatGPT 把脚本改成 Playwright。但在这次测试中,BeautifulSoup 已经够用了。
第 5 步:搭建 Python 项目
在 ChatGPT 生成抓取工具后,我需要在本地运行它。
首先,我创建了一个新文件夹:
然后我创建了一个虚拟环境。
在 macOS 上,我使用的是:
然后我激活了它:
在 Windows 上,激活命令为:
然后我安装了这些包:
然后我快速检查了 Python 是否能够导入它们:
如果 pip install 因 NameResolutionError 而失败,我会先检查网络连接。就我的情况而言,命令本身是对的,但如果终端因为 DNS、防火墙、VPN 或网络限制而无法访问 PyPI,软件包安装就可能失败。
如果抓取脚本之后出现 ModuleNotFoundError: No module named ‘requests’,这通常意味着安装没有完成,或者虚拟环境未激活。
第 6 步:创建抓取程序文件
配置准备好之后,我创建了 Python 文件:
然后我在文本编辑器中打开了它。
在 macOS 上,这样可能有效:
如果该命令不起作用,我会使用任意代码编辑器,或者直接从文件夹中打开文件。终端的备用方案是:
我把 ChatGPT 生成的代码粘贴到文件里并保存。
脚本大致是这样的:
第 7 步:运行抓取器并检查 CSV
然后我运行了脚本:
它创建了一个名为以下名称的 CSV 文件:
books_to_scrape_products.csv
要在 macOS 上打开并检查该 CSV,请运行:
输出结果包含了我想要的字段。
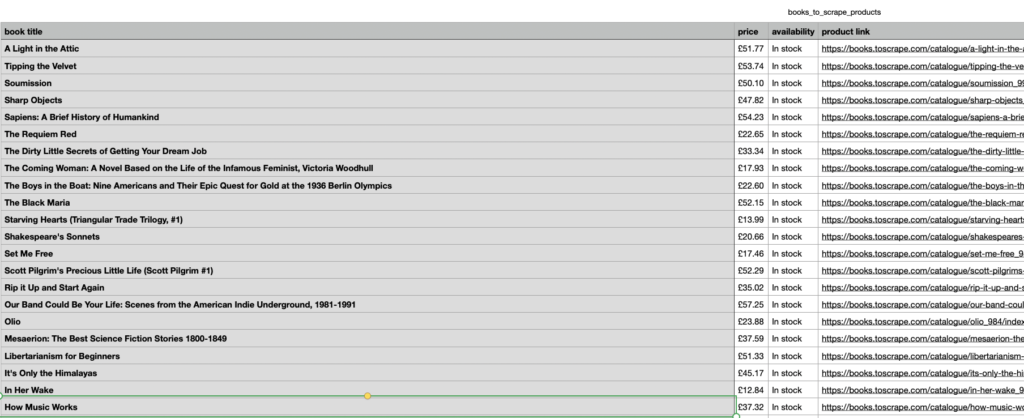
ChatGPT 帮我构建了一个抓取程序,它可以打开页面、提取结构化数据,并将其保存为可用的 CSV。
第 8 步:让 ChatGPT 抓取多个页面
第一个版本只抓取了第一页。
Books to Scrape 共有 50 页,因此下一步显而易见:让 ChatGPT 添加分页功能。
我使用了这个提示词:
这个抓取脚本对第一页有效。

请更新它,使其抓取 Books to Scrape 上的所有页面。

该网站有分页。
请一直跟随“next”链接,直到没有更多页面为止。

保持相同的 CSV 列:
- 书名
- 价格
- 库存情况
- 商品链接
ChatGPT 更新了脚本,让它可以跟进下一页的链接。
第 9 步:添加基础的调试和重试逻辑
抓取器可以运行,但并不完美。它抓取了前五页,然后第 6 页超时了。
终端显示:
正在抓取第 6 页:https://books.toscrape.com/catalogue/page-6.html
页面获取失败
连接超时
第 6 页失败,已跳过
已将 100 本书保存至 books_to_scrape_products.csv
然后我让 ChatGPT 改进这个脚本:
抓取工具可以运行,但第 6 页超时了。

请更新脚本,使其:
- 对失败的页面最多重试 3 次
- 每次重试之间等待 3 秒
- 将请求超时时间增加到 30 秒
- 如果某个页面在重试后仍然失败,则继续抓取
- 最后将所有成功抓取的产品保存到 CSV 文件中
这类修复在真实的抓取工作中很重要。即使是简单的网站也可能超时。在大型电商网站上,重试、超时、日志以及干净的代理会话都不是可有可无的。
第 10 步:为防护更严的网站添加代理
Books to Scrape 证明了这个抓取脚本可以正常工作。但对于真实的电商网站、市场平台、搜索结果或评论平台,我不会使用同样简单的配置。
这些网站通常有反机器人系统、速率限制、区域内容和更严格的 IP 检查。如果每个请求都来自同一个本地 IP、办公室 Wi-Fi、云服务器或免费 VPN,抓取程序就可能开始被拦截、被要求验证或返回不完整的页面。
这正是我建议添加代理的地方。
我会在抓取脚本通过小规模测试后再添加它们。首先,我想确认代码是否正确。然后我再添加代理,让访问层更加稳定。
在抓取过程中,代理有助于:
- 在测试时保持稳定的会话
- 从特定国家、城市或 ZIP 代码进行抓取
- 按 IP 会话区分不同的抓取任务
- 减少对被过度使用的 VPN 或数据中心 IP 的依赖
- 查询区域价格、库存情况或搜索结果
- 诊断故障是由代码问题还是访问问题引起的
在 NodeMaven 中,我会像这样创建一个代理配置:
- 代理类型: 住宅代理
- 位置:根据目标市场
- 会话类型:轮换
- 协议:HTTP
- 主机:gate.nodemaven.com
- 端口: 8080
- 来自仪表板的用户名和密码
然后在终端中设置代理凭据,而不是直接写在 Python 文件里。
在 macOS 或 Linux 上:
在 Windows PowerShell 上:
然后用以下提示词让 ChatGPT 更新抓取工具:
该抓取脚本已能在测试网站上运行。

现在添加带身份验证的 NodeMaven 代理支持。

使用环境变量保存凭据:
- NODEMAVEN_PROXY_USERNAME
- NODEMAVEN_PROXY_PASSWORD

代理服务器:
http://gate.nodemaven.com:8080

另外添加:
- 超时处理
- 失败 URL 日志记录
- 重试逻辑
- 拦截页面检测
- 缺少代理凭据时给出清晰的错误提示
对于一个 requests 爬虫来说,代理配置大致是这样的:
这样可以让凭据不出现在 Python 文件中。它还让抓取脚本更安全,便于分享、截图或提交到代码仓库。
这正是 ChatGPT 自身无法解决的部分。它可以编写抓取程序,但无法让低质量的 IP 变得更受信任,无法添加 IP 轮换,也无法在受保护的网站上保持会话稳定。干净的住宅代理、粘性会话和位置定向能为抓取程序提供更好的运行环境。
为什么 NodeMaven 适合 ChatGPT 网页抓取工作流
NodeMaven 在这里很有用,因为它能解决 ChatGPT 无法解决的部分:访问质量。
NodeMaven 可以帮助你实现:
- 干净的轮换住宅 IP,实现更自然的访问
- 用于较长抓取运行的粘性会话
- 国家/地区、城市、ISP 和 ZIP 定向
- 支持 SOCKS5 和 HTTP
- 以质量为核心的筛选模式
- 住宅套餐包含移动代理
- 质量保证 以及在相关情况下的返现
干净的 IP 和稳定的会话让你更容易把代码问题和访问问题区分开来。如果一个爬虫在干净的环境下失败,我就知道该去检查选择器、JavaScript 或页面结构,而不是盲目地猜测。
ChatGPT 抓取工具 vs 抓取 API
测试之后,我会这样划分这些工具:
| 设置 | 最适合 | 限制 |
|---|---|---|
| 具备网络访问的 ChatGPT | 少量的手动查询 | 无法扩展的结构化抓取 |
| ChatGPT + BeautifulSoup | 像 Books to Scrape 这样的静态页面 | 在大量使用 JavaScript 的网站上会失效 |
| ChatGPT + Playwright | 动态页面 | 速度更慢,资源占用更多 |
| ChatGPT + NodeMaven 代理 | 具备更好访问控制的真实抓取工作流程 | 代理的额外成本 |
| 数据采集 API | 托管式渲染、重试和基础设施 | 对自定义逻辑的控制较少 |
| MCP 风格的工具 | 研究与原型开发 | 并非总是可用于生产环境 |
MCP 也值得关注。与其让 ChatGPT 编写代码再单独运行,不如用 MCP 将 AI 助手连接到外部工具。OpenAI 提供了 MCP 及连接器的文档,用于将模型连接到外部系统。
Final Takeaway
ChatGPT 能帮助进行网页抓取,但它并不是一套完整的抓取技术栈。
它可以帮你快速构建一个可用的抓取器,但对于带有反机器人系统的网站,例如 Amazon,你仍然需要干净的基础设施、稳定的会话、日志记录、重试和数据校验。
我得到的实用结论很简单:
- 使用 ChatGPT 构建并调试抓取程序。
- 使用 Python 或 Playwright 来运行它。
- 当工作流程需要 IP 轮换、稳定访问、位置控制和更干净的 IP 时,请使用 NodeMaven 代理。

使用 NodeMaven 住宅、移动和 ISP 代理,享受粘性会话、地理定位、SOCKS5/HTTP 支持以及经过预筛选的纯净 IP。仅需 $3.50 即可获得 750MB 起步流量。


