
如何批量检查 URL 列表的 Meta 标签(以及失败时该怎么办)


查看单个页面的 meta 标签只需右键点击一下。而批量检查一组 URL 的 meta 标签则是另一回事,共有四种实用的做法。
- 基于浏览器的批量检查工具。 粘贴列表,查看结果,导出 CSV。完全无需任何设置。
- 桌面爬虫工具 ,例如 Screaming Frog 或 Sitebulb。它们的设计初衷是在整个网站范围内发现 URL,而不是检查你已经掌握的那些 URL。
- Python 脚本。 没有 URL 数量上限,可以完全掌控每一个字段,但这个爬虫从此也要由你自己来维护。
- 电子表格公式。
IMPORTXML在 Google Sheets 中,免费又熟悉,直到页面不再配合为止。
每种方法都在不同的场景中胜出,也会以不同的方式失效。下面我们会逐一讲解这四种方法各自的优势与局限,不过先来快速看看你实际要采集的是什么。
页面的 <head>
这里的所有内容都来自同一个位置:HTML <head> ,也就是公开页面的头部。以下是值得采集的字段。
| 字段 | 它决定什么 | 常见问题 |
|---|---|---|
<title> | 搜索结果和浏览器标签页中显示的标题 | 缺失、重复,或超过约 60 个字符被截断 |
meta 描述 | 搜索结果下方的摘要文字 | 缺失,或是为其他页面撰写的 |
link rel="canonical" | 声明该页面的首选版本 | 迁移后指向了错误的 URL |
meta robots | 索引与抓取指令 | 一个误留的 noindex 从预发布环境遗留下来 |
og:title, og:description, og:image | Facebook 和 LinkedIn 显示的内容 | 缺少图片,分享卡片显示为灰色 |
twitter:card, twitter:title | X 显示的内容 | 缺失时回退到 Open Graph,有时效果很差 |
hreflang | 映射语言和地区版本 | 缺少回指标签,或自引用错误 |
JSON-LD <script> | 用于丰富搜索结果的结构化数据 | 语法有效,但描述的实体不对 |
其中任何一项手动检查都很容易。麻烦在于数量,而当部分页面拒绝响应时,问题会成倍放大。
批量检查一组 URL 的 meta 标签的四种方法
1. 基于浏览器的批量检查工具
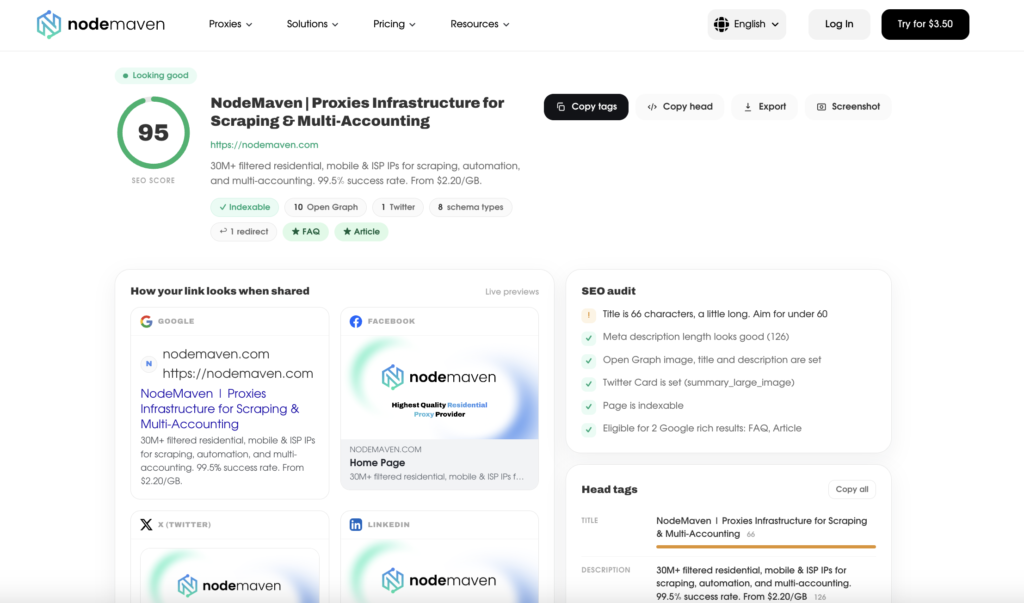
粘贴你的列表,运行,然后查看结果。 NodeMaven 的 meta 标签检查器 每次运行最多可处理 50 个 URL。
它会返回标题、描述、canonical、robots 指令、schema 类型、Open Graph 与 Twitter Card 数据,以及每个链接在 Google, Facebook, X 和 LinkedIn上的实时渲染预览。结果可导出为 CSV,你还可以复制单个标签或整个页面的头部内容。
从这里入手的理由是:无需安装,也无需维护。对于上线前的 QA 检查、迁移后的抽查或竞品对比来说,其他任何方法的搭建成本都比任务本身还高。
它的局限: 每次运行 50 个 URL,没有公开 API,也不做站点发现。列表需要你自己提供,工具不会替你去找。
2. 桌面端爬虫
Screaming Frog 和 Sitebulb 解决的是另一类问题。它们从一个域名出发,沿着链接发现 URL,这正是你对一个从未见过的网站做完整技术审计时所需要的。
正是这一发现步骤,也让它们不适合处理已知的 URL 列表。安装爬虫、配置它、等待抓取完成,只为检查电子表格里现成的三十个 URL,这些工作毫无价值。
Screaming Frog 的免费版上限为 500 个 URL。 按当前定价,授权费约为每年 259 美元。
它的局限: 对小任务来说过于笨重,仅限桌面端,而且在真实网站上很快就会触及免费额度上限。
3. Python
二十行代码就能得到一个可重复运行、没有 URL 数量上限的脚本:
python
import csv, httpx
from selectolax.parser import HTMLParser

def get_meta(url):
    r = httpx.get(url, follow_redirects=True, timeout=15,
                  headers={"User-Agent": "Mozilla/5.0"})
    tree = HTMLParser(r.text)

    def attr(selector, name="content"):
        node = tree.css_first(selector)
        return node.attributes.get(name, "") if node else ""

    title = tree.css_first("title")
    return {
        "url": url,
        "final_url": str(r.url),
        "status": r.status_code,
        "title": title.text() if title else "",
        "description": attr('meta[name="description"]'),
        "canonical": attr('link[rel="canonical"]', "href"),
        "robots": attr('meta[name="robots"]'),
        "og_title": attr('meta[property="og:title"]'),
        "og_image": attr('meta[property="og:image"]'),
    }

with open("urls.txt") as f:
    rows = [get_meta(line.strip()) for line in f if line.strip()]

with open("meta.csv", "w", newline="") as f:
    writer = csv.DictWriter(f, fieldnames=rows[0].keys())
    writer.writeheader()
    writer.writerows(rows)
请注意 final_url 字段。记录请求实际落到哪里只需一行代码,却能捕捉到一整类静默错误,下一节会讲到这些。
当检查需要按计划定时运行、需要向其他系统输送数据,或需要覆盖成千上万个 URL 时,这就是正确的答案。
它的局限: 你现在拥有的是一个爬虫。下面提到的每一种失败模式都要由你来处理,首先就是这个事实:该脚本只能看到服务器返回的 HTML,看不到浏览器随后构建的任何内容。
4. 电子表格公式
Google Sheets 完全不需要任何工具就能做到这一点。把 URL 放在 A 列,然后:
=IMPORTXML(A2, "//title")
=IMPORTXML(A2, "//meta[@name='description']/@content")
=IMPORTXML(A2, "//link[@rel='canonical']/@href")
免费、熟悉,用来处理十个 URL 确实够用。
它的局限: IMPORTXML 抓取的是原始 HTML,因此任何由 JavaScript 渲染的内容都会返回空值。Sheets 的速率限制也很严格,一列五十个公式同时重算就会开始抛出 #N/A 自行出现。由于没有状态码,被拦截的页面和没有标题的页面看起来完全一样。
哪种方法适合哪种任务
| 方法 | 设置 | URL limit | 可读取 JS 内容 | 应对拦截 | 导出 |
|---|---|---|---|---|---|
| 浏览器检测工具 | 无 | 每次运行 50 个 | 支持,需开启浏览器模式 | Built in | CSV |
| 桌面端爬虫 | 安装 + 配置 | 500 free | 需启用渲染 | 手动配置 | CSV, Excel |
| Python 语言 | 编写 + 维护 | 无 | 仅限使用无头浏览器 | 需自行搭建 | Anything |
| Sheets 公式 | 无 | 实际约为 10 | 否 | 否 | 原生支持 |
为什么批量元数据检查会得出错误结果
以上任何一种方法,其原理都是一样的:请求一个 URL,读取 <head>,写入一行数据。有五种情况会打断这条链路,而其中大多数与页面的元数据毫无关系。
一条规则适用于全部五种情况:逐级升级,不要一上来就用重型方案。先用最廉价的方式跑完整个列表,只对失败的条目启用浏览器渲染重跑,然后再用另一个 IP 重跑仍然失败的部分。大多数 URL 根本用不上昂贵的路径。
从这里开始:把症状对应到原因
| 你看到的现象 | 最可能的原因 |
|---|---|
| 标题为空,但页面在 Chrome 中显示正常 | JavaScript 渲染 |
| 多个互不相关的域名出现相同标题 | 是机器人防护在应答 |
| 前几行正常,后面的行为空 | 速率限制 |
| 数据都填上了,但数值看起来不对 | 因国家/地区而异的内容 |
| 返回了你并未请求的页面的完整数据 | 重定向或软 404 |
页面用 JavaScript 生成标题
你在 Chrome 里打开这个 URL,标题就明明白白显示在标签页上,但你的脚本却什么也没返回。这两个现象都没错。
服务器发回的是一个近乎空白的 HTML 外壳,是你的浏览器运行 JavaScript 把内容填了进去。没有服务端渲染的 React、Vue、Angular 和 Next.js 应用都是这样。还有很多网站虽然大部分内容由服务端渲染,但 Open Graph 标签是在客户端注入的。
如何确认: 打开 view-source: 而不是查看检查器。前者显示的是服务器发送的内容,后者显示的是浏览器构建出来的内容。如果标题只出现在后者而不在前者中,答案就清楚了。
解决办法: 渲染页面。也就是在检测工具中使用浏览器模式、在爬虫中开启 JavaScript 渲染,或者在脚本中用 Playwright 取代 HTTPX 库 。渲染既慢又重,所以只把它留给确实需要的 URL。
是机器人防护在应答,而不是页面本身
Cloudflare、Akamai 和 DataDome 挡在很大一部分商业网站前面。当它们判定某个请求像是自动化行为时,就会返回一个验证挑战页面。该页面有状态码、有 HTML,也有它自己完全合法的 <title>,通常是类似“Just a moment…”这样的内容。
这比返回空结果更糟糕,因为它看起来并不像一次失败。你会得到一个填好了内容、但内容是错的单元格。除非你逐一查看这些值,否则根本不会察觉。
如何确认: 把导出结果按标题排序。如果毫不相关的域名共用同一个标题,说明你反复抓到的是同一个验证挑战页面。
解决办法: 一个真实的浏览器指纹,以及一个看起来不像数据中心的 IP。如果你的请求来自某个云服务商的地址段,有些网站无论请求构造得多完美都会拒绝。任何解析逻辑都绕不过这一点,这正是 住宅代理 存在的意义。
你触发了速率限制
在十秒内向同一域名发出五十次请求,这不是正常的浏览行为。大型出版商、电商平台以及任何位于 CDN 之后的站点,都会在任务进行到一半时开始返回 429、超时或空响应体。
这个迹象与位置有关。靠前的 URL 成功,靠后的失败,而这种规律不可能由页面本身的问题造成。
如何确认: 单独重跑那些失败的项。如果它们单独运行时通过,那么问题从来就不在页面上。
解决办法: 放慢速度、分散请求。在请求之间加入延迟,限制每个域名的并发数,对较大的任务轮换源 IP。指向同一域名的 50 个 URL 列表,比分布在 50 个域名上的 50 个 URL 需要更谨慎的处理。
该页面按国家/地区提供不同的元数据
国际化站点会按地区改变标题和描述,将访客重定向到国家子目录,或根据请求来源提供不同的 hreflang 集合。
审计 example.com/product from Istanbul and you may be reading the Turkish page. Your German colleague runs the same check and gets different values. Neither of you is wrong.
如何确认: 将你请求的 URL 与实际响应的 URL 进行对比。重定向到国家子目录是这个问题的可见版本。不可见的版本则保留 URL 而替换内容。
解决办法: 从你关心的国家/地区进行检查。这一点很容易被低估,因此下一节会详细拆解它。
错误页面返回 200 状态码
软 404 会用成功状态码返回一个错误页面。重定向链会把你带到并非目标的位置。无论哪种情况,元数据都是真实且完整的,只是它描述的是另一个 URL,而不是你表格里的那一个。
如何确认: 把最终 URL 与请求的 URL 一并记录下来,对比这两列。
解决办法: 不需要任何技术手段。读一读这两列即可。它不花任何成本,却能抓出那些最像干净数据的错误。
你在单一国家看不到的元数据
如果你只从单一地点审计一个国际化站点,那你审计的只是它的其中一个版本。
假设一个页面带有德语标题、法语标题和英语兜底标题。从一个 IP 你只能看到其中一个。另外两个始终不可见,而你的导出文件里没有任何线索表明它们存在。表面上一切正常。CSV 里没有空白,而你的德国客户所看到的标题从未进入这份表格。
同样的情况也适用于 hreflang。同一个页面可能在一个地区声明完整的语言备用版本集合,而在另一个地区只声明其中一部分。仅从单一国家检查返回标签,会让你看到一份对其他所有人都是失效的“有效”配置。
任何有国际流量的站点都值得运行以下三项检查:
- 请求的 URL 是否原样保留? 把你请求的地址和实际响应的地址做对比。如果被重定向到某个国家的子目录,那么后面每一个字段描述的都是另一个页面。
- URL 没变,标题却变了? 同一个地址,不同的内容,响应中却没有任何信号。这正是能躲过所有审计的那一种。
- 各地区返回的
hreflang组是否一致? 缺少回指标签是错误语言在错误市场获得排名的常见原因。
这三种情况都意味着要从你关心的那个国家发出请求,而这正是 用于网页抓取的代理 存在的意义。
不过要把原因说清楚。在这里,代理是测量工具,而不是绕过封锁系统的手段。从土耳其审计德国的元数据,就像用一门你读不懂的语言去校对译文。
50 个 URL 审计的实用工作流
- 导出 URL 列表 来自你的站点地图、Search Console 或 CMS。每次运行请控制在 50 个以内。
- 先用默认抓取模式跑一遍全部内容。 大多数 URL 都能解析成功,而这一遍低成本的抓取会告诉你哪些不行。
- 在查看空白项之前,先按标题排序。 互不相关的域名却出现完全相同的标题,说明是机器人防护在应答。这就是那种会被隐藏起来的失败。
- 把请求的 URL 和最终的 URL 做对比。 只要有任何不一致,该行中其他所有字段都不再有效。
- 对失败的项目改用浏览器渲染重新抓取。 这样可以找回由 JavaScript 生成的页面,以及一部分受保护的页面。
- 凡是与地区相关的内容,都从目标国家重新抓取一次。 仅适用于国际化网站,且仅针对具有商业价值的页面。
- 导出为 CSV 并按问题排序 而不是按 URL 排序。缺失的标题、缺失的描述以及误设的
noindex指令是三类彼此独立的工单,按问题排序能把同类工作归拢到一起。


