
2026 年最佳 AI 网页爬取技术栈


想弄清楚在 2026 年哪些 AI 抓取工具真正值得在其之上构建,而哪些只是在传统抓取工具上硬加了一个 LLM?
本文面向正在选择 AI 驱动抓取技术栈的开发者和数据团队,内容汇集自从业者当下正在讨论和测试的经验,并与各工具自身的文档和定价进行了交叉核对。
真正区分这些工具的因素
在给任何工具排名之前,有三个问题能决定一款 AI 抓取工具是否经得起演示之外的考验:
- 它是生成一个完整的爬虫,还是只对你已经抓取到的内容进行格式化? 有些工具(ScrapeOps、ScrapeGraphAI)会运行整条流水线——抓取、渲染、提取。另一些(LLM Scraper、Scrapy-LLM)则是一个层,你可以把它嵌入到你已经拥有的流水线中。
- 遇到杂乱、不规则的标记时会发生什么? 嵌套的 div、折叠面板和不一致的布局,正是 AI 提取工具最常从读取转为猜测的地方,值得在你自己最糟糕的实际页面上测试,而不是在供应商的演示页面上。
- 代理从哪里来? 这些工具中的每一款,要么通过其自带的捆绑代理池(通常有标记),或者要求你自带一个。仅凭这一点,对你实际成本的影响就超过了清单上的任何一项功能。
2026 年的 AI 网页抓取技术栈:由 Nodemaven 团队评测
Firecrawl
将任意 URL 转换为干净的 markdown 或结构化 JSON,专为 LLM 和 RAG 流水线打造,具备原生 LangChain/LlamaIndex 集成,以及面向 AI 编码智能体的 MCP 服务器。
它是这里最容易上手的工具,而且在结构简单的页面上,提取质量确实很强。
问题出在积分系统上:标准抓取消耗 1 个积分,但一旦目标启用了 Cloudflare 之类的防护,你就需要用到的隐身模式(Stealth Mode)会跳升至每页 5 个积分,AI 驱动的提取同样消耗 5 个积分。
先爬取再提取的工作流每页可能消耗 7 个额度,而不是 1 个,这是团队在查看自己的用量后最常报告的意外情况 实际账单与 $16/月 的标价对比. 定价仅提供订阅制,未用完的额度不会结转到下个周期。
最适合: 适合需要快速从任意 URL 获取干净文本的 AI/RAG 产品。
ScrapeGraphAI
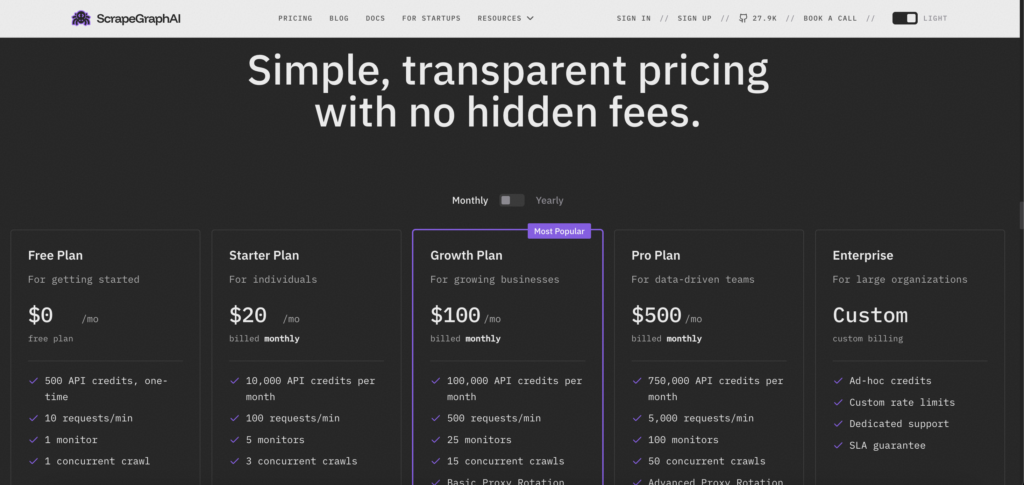
一个以 AI 为核心的平台,围绕一个简单的理念构建:在提示词中描述你想要的内容,基于图的流水线便会把页面转换为带类型、经 schema 校验的 JSON。
由于它是从语义层面推理页面结构,而非匹配固定的选择器,因此它的设计目标是在网站移动某个价格元素的位置或重命名某个 CSS 类时仍能持续工作,而这正是传统抓取程序失效的确切模式.
代价是每页成本。估算显示 SmartScraper 每页约 $0.021,而 Firecrawl 完成同类抓取每页约 $0.004.
你为每一次请求都要支付一次 LLM 调用费用,在真实规模下这笔开销会迅速累积。而且它也更 它更偏向面向开发者,而非对新手友好;如果你想要一款可视化的无代码工具,那这款并不合适。
最适合: 想要类型化、经过校验的 JSON 输出,并且能够承受每页 LLM 成本的开发者。
ScrapeOps
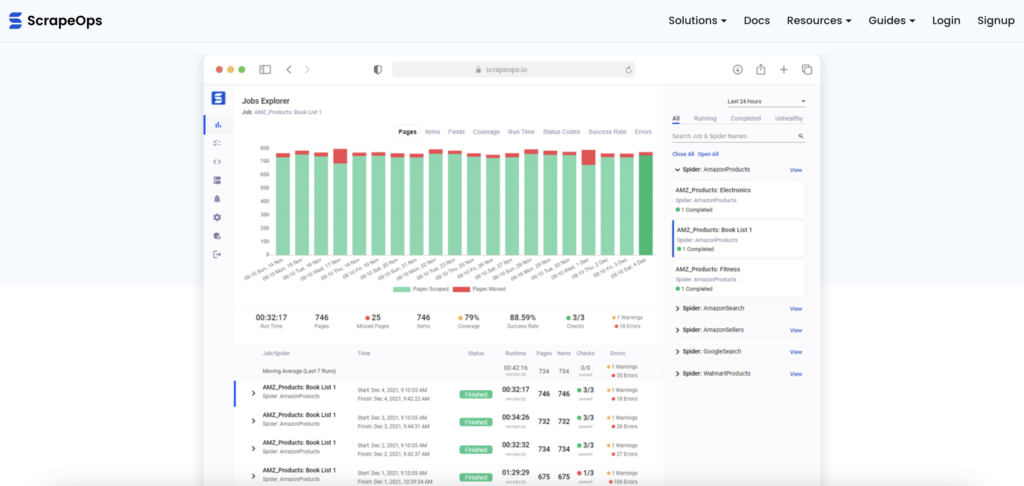
与其说是 AI 提取工具,不如说更像是一款 AI 辅助的抓取工具 生成器:最多提供五个商品页面 URL,选择 Python 或 Node.js 以及一个库,然后 它会分析页面结构并编写一个完整、可用的抓取程序,其中包括一个自我修复步骤,用真实页面数据测试代码,并自动修正返回错误的字段.
这确实比本列表中的大多数工具更接近可投入生产的状态。但它生成的是提取代码,而非其底层的基础设施。 生成的爬虫上线后,你仍需自行负责搭建代理和处理速率限制。AI 层大概去掉了整个工作流的五分之一,而基础设施层仍然占据其余的五分之四。
最适合: 适合那些希望针对已知页面类型(产品、搜索、分类)生成一个真正可用的初始抓取器,而不想从零开始编写的团队。
Crawl4AI
Firecrawl 的开源替代方案——GitHub 星标超过 6 万,采用 Apache 2.0 许可,专为输出干净的 markdown 而构建,服务于 RAG 和 agent 流程,支持基于 CSS、XPath 或 LLM 的提取策略。
没有额度系统,没有厂商锁定,独立基准测试还显示,在同类任务上它比 Firecrawl 快出数倍。
这种取舍正是你对开源软件所能预料到的: 无托管服务。你自己掌控基础设施:代理、扩展、重试,以及跟进目标网站的任何变更。对于拥有真正 Python/DevOps 能力、又不想按请求计费的团队来说,这是正确的取舍;但如果你想要一个开箱即用、零运维的方案,那就是错误的选择。
最适合: 想要完全掌控、并且乐于自己承担运维一端的开发者。
LLM Scraper 与 Scrapy-LLM
两者都是库,而非平台。
它们把基于 LLM 的提取嵌入到你已有的抓取技术栈中(LLM Scraper 用 Node/TypeScript,Scrapy-LLM 用 Python/Scrapy),而不是取而代之。LLM Scraper 对 Playwright 的完整支持,使其成为已在该生态中得心应手的团队相当受欢迎的选择。
两者在实际提取步骤上都仍然依赖外部 LLM,因此你会继承与任何 AI 提取工具相同的提示词调优和边缘情况处理问题。
最适合: 已经在运行 Scrapy 或 Node 抓取技术栈、希望在不更换平台的情况下加入 AI 提取能力的团队。
AutoScraper 库(GitHub)
这是一个轻量级的开源库,使用小型本地模型以降低计算成本。你只需定义一次想要的项目,它便能学会在目标网站上找到类似的模式。设置快捷,对于快速原型和一次性任务确实很实用。
它一直被指出并非为更大规模的生产工作负载而设计。 把它当作在投入更重的工具之前快速验证一个想法的方式。
最适合: 快速原型和一次性提取任务,而非持续的生产环境抓取。
Browse AI
一个无需代码的可视化平台。
你只需录制自己在页面上点击操作一次,机器人就会学会这个模式,并按计划重复执行,还能自动适应细微的布局变化(比如按钮位置移动、出现新的弹窗)。 代理和调度都会为你处理好。
它专为周期性的、非技术性的提取任务而打造。在这里,可靠性比原始速度或一次性规模更重要,胜过反复重做。 对于单次的大规模一次性爬取,它并不是合适的工具。
最适合: 需要长期反复监测相同页面的非技术团队。
Octoparse
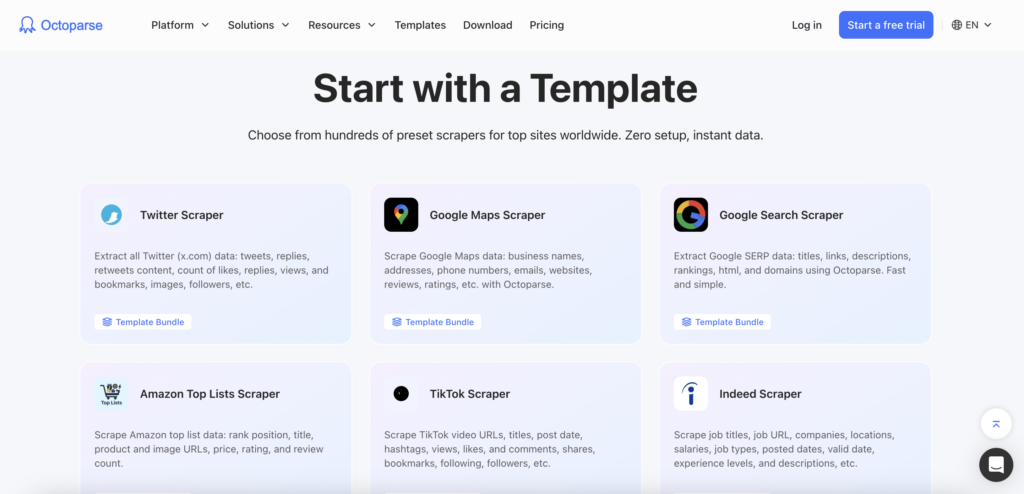
一款可视化、无代码的抓取工具,具备 AI 自动识别数据字段、600 多个现成模板,以及内置 IP 轮换和 CAPTCHA 破解的云端执行能力。 在那些以无限滚动或激进反爬层主动对抗的网站上,它确实很有用。
价格从每月约 69-89 美元起,而且代理/CAPTCHA 的使用会在此之上单独计费(据独立定价拆解,住宅代理为每 GB 3 美元),在你决定采用前值得先纳入预算,因为基础订阅并不涵盖这部分。
它还仅支持 Windows/Mac,其工作流构建器不支持 Linux。
最适合: 面向那些遭遇真正棘手目标、而更简单的无代码工具无法应对的非技术团队。
Apify
一个拥有 35,000+ 预构建组件的市场 Actors 覆盖大多数主流平台(Instagram, Amazon, Google Maps, LinkedIn),如果你想自己搭建,还可以使用开源的 Crawlee SDK。现在有几个 Actor 在底层抓取之上叠加了 AI 提取能力。
最常见的预算意外来自: r住宅代理流量,按大约 $8/GB 单独计费。
针对受保护目标的一次 JavaScript 密集型运行 可以在几天内耗尽一个29美元入门套餐的全部积分额度,平台页面上的计算单元定价 在那一项费用出现之前看起来很便宜.
最适合: 在不搭建任何东西的情况下抓取某个已知平台,或使用现成的构建模块编排一条多步骤流水线。
steel.dev
一款开源、云原生、专为 AI 智能体打造的浏览器 API。
以编程方式启动真实的 Chrome 会话,让它们保持活跃长达24小时,并通过以下方式连接 Playwright, Puppeteer,或 Selenium 而无需你自己管理浏览器基础设施。据报告,它通过返回更干净的提取内容而非原始页面转储,显著降低了 LLM token 的使用量。
它是一个浏览器与会话层,而非抓取工具。 你仍需搭配自己的 AI 解析环节 (或本列表中的其他工具)叠加在其之上。 代理带宽 以及 CAPTCHA 破解会按使用层级单独计量。
最适合: 需要真实、持久的浏览器会话,而非一次性页面抓取的智能体式工作流。
你需要代理的地方
| 工具 | 是否捆绑代理? | 已经提供的内容 | 你能自带(BYO)吗? | 结论 |
|---|---|---|---|---|
| Firecrawl | 是 | 包含在订阅套餐中。 Stealth Mode = 每页 5 个额度,而不是 1 个 | 不能,代理已固化在架构中,无法替换成你自己的 | 无法自带代理。如果目标网站受到保护,你就得支付 5 倍的费率,别无他法 |
| ScrapeGraphAI | 是 | 包含在 每页 LLM 成本 (约 $0.021/页) | 否,代理是托管管道的一部分 | 与 Firecrawl 一样,加价已计入价格,无法绕过 |
| ScrapeOps | 否(在 AI Scraper Builder 中) | 仅生成抓取器代码, 不含代理 | 是的,必需 | 没有代理,生成的爬虫将无法绕过检测 |
| Crawl4AI | 否 | 开源,自托管,完全不含任何基础设施 | 是的,必需 | 百分之百需要你自己的 |
| LLM Scraper / Scrapy-LLM | 否 | 库,而不是一个平台 | 是的,必需 | 代理完全由你自行负责 |
| AutoScraper | 否 | 本地库 | 是的,必需 | 对于针对简单目标的轻量原型,你可以跳过它,但任何更认真的任务都需要代理 |
| Browse AI | 是 | 捆绑, 没有可见性或控制权 | 否 | 已计入套餐 |
| Octoparse | 部分支持 | 云端运行时已捆绑提供, 但会单独计费 ($3/GB) | 仅在 本地模式 (免费使用你自己的 IP) | 你被锁定在他们的 $3/GB 上,无法自带代理 |
| Apify | 是的,作为附加项 | 住宅代理附加项约 $8/GB | 可以,许多 Actor 允许你设置一个 自定义代理组 | 从技术上讲你可以自带,但请先查看具体的 Actor |
| steel.dev | 是 | 代理带宽 按套餐档位计量 | 未公开记录 | 很可能已内置于会话基础设施中,与 Firecrawl/Browse AI 相同 |
选择你的技术栈(快速指南)
| 如果你…… | 使用 | 注意 |
|---|---|---|
| 正在构建 AI/RAG 产品,并需要快速获得干净的 markdown | Firecrawl | 为 Stealth Mode 的倍率预留预算 |
| 希望获得带类型、经校验、且能在布局变化后依然可用的 JSON | ScrapeGraphAI | 仅当每页的 LLM 成本符合你的用量时才划算 |
| 希望为已知的页面类型获得一个真正生成的抓取器 | ScrapeOps | 需单独预留预算用于 高质量代理 |
| 希望对工具拥有更多掌控,并且不想为捆绑的代理多付钱 | Crawl4AI 或 LLM Scraper/Scrapy-LLM | 将它与 NodeMaven 搭配使用 住宅代理,它们在速度上势均力敌。用以下方式核对你的预期用量: 我们的免费代理检测工具 → |
| 运行非技术性的、周期性的监控任务 | Browse AI | — |
| 面对有敌意的目标网站,并需要无代码方案 | Octoparse | 为代理/CAPTCHA 附加项预留预算 |
| 针对某个已知平台,并且不想自己搭建任何东西 | Apify | 了解住宅代理 |
| 已有提取逻辑,只需要可靠的访问通道 | ScraperAPI | — |
| 需要带有真实浏览器会话的智能体工作流 | steel.dev | — |
那么,2026 年最佳的 AI 抓取技术栈是什么?
如今没人再去挑选唯一一款最好的工具了。 那些对自己方案最满意的团队,会把这项工作拆成两个独立的决策,并按各自的标准分别挑选。
第一个决策是提取,在这一点上,AI 确实名副其实。当一个网站悄悄地重命名某个 CSS 类时,能够随之调整的提示词,胜过当天下午就失效的选择器。至于选择 Firecrawl 的 markdown、ScrapeGraphAI 的类型化 JSON,还是像 Crawl4AI 或 LLM Scraper 这样自托管的方案,则取决于你的预算,以及你实际想要掌控多少基础设施。
第二个决定才是悄悄决定你整份账单的关键:首先要让请求成功通过。而在梳理这一切的过程中,最让我们意外的是—— 关于 AI 时代 抓取过程完全没有触及这一部分。说白了,它仍然是一个代理问题。
所以没错,抓取确实正在向 AI 提取转变,而且这一转变并没有放缓。但它并没有让互联网对其页面的保护有丝毫减弱。 到 2026 年真正胜出的技术栈,是把提取与访问当作两个独立问题来处理的那种,而不是那款承诺一次性解决两者的单一工具。


