
什么是 AI 数据采集?[概述、方法与伦理洞察]


你是否好奇过 AI 系统是如何积累海量数据集(文本、图像、音频、传感器日志),并将其转化为强大模型的?AI 数据采集正是这一切背后的引擎。无论是从网络抓取的文本,还是通过众包标注的用户输入,AI 都依赖于有条不紊的数据管道来驱动学习。
在大规模操作中,代理,尤其是轮换的住宅代理或移动代理,在提供保持隐蔽、地理精确且不间断的访问方面发挥着关键作用。
本篇博客将详细拆解整个 AI 数据采集流程、所涉及的工具、面临的挑战,以及代理如何帮助安全地扩展这一切。
什么是 AI 数据采集?
数据是任何 AI 背后的原始燃料:无论是结构化还是非结构化,经过整理还是未经过滤。
从本质上讲,AI 数据收集是指采集结构化或非结构化信息的过程,涵盖从网页、图像到带标签的人工输入和设备遥测数据的方方面面,用于训练或优化模型。
这不仅仅是收集海量原始数据;它还需要有目的地进行数据溯源、标注和结构化处理,从而使数据可供使用。
这不仅仅关乎数量,更关乎采集到 正确 数据、对其进行标注和清洗,并将其结构化以用于机器学习。
在实践中,这些数据随后会输入到更广泛的模型开发工作流程中,以及诸如 G2 的相关指南等资源 机器学习平台 概述这些系统是如何用于大规模训练、部署和管理模型的。
在很多情况下,爬取和自动化采集工具需要集成代理,以避免 IP 被封禁,并保持数据集在地域上的准确性。
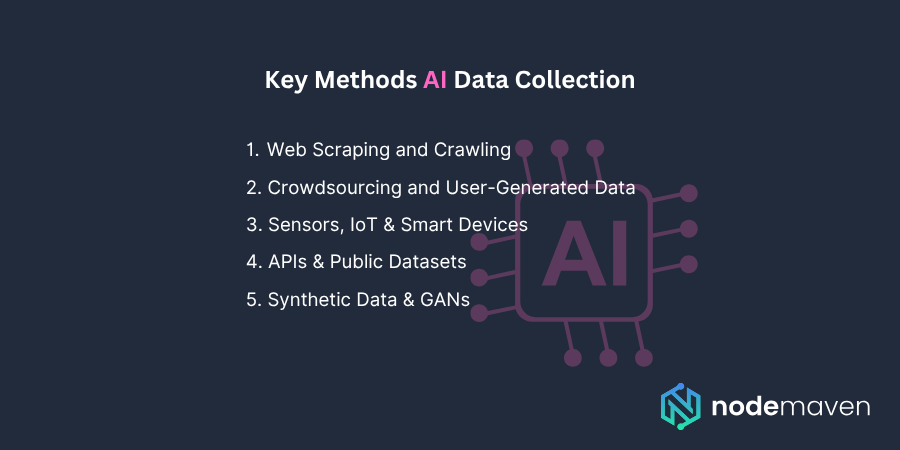
AI 数据采集的关键方法
AI 数据收集通过多种渠道进行,每种渠道都适用于不同类型的训练需求和项目范围。
网页爬取与抓取
当需要大量文本或元数据时, 网络爬虫 成为 AI 数据收集的首选方法。AI 系统会爬取博客、新闻媒体、电商页面和论坛。
网站会封禁发送过多请求的 IP。代理正是在这时派上用场:轮换代理,尤其是住宅代理或移动代理,会按每次请求或每个会话轮换 IP,从而分散请求负载并避免被检测到。
使用像 NodeMaven 所提供的代理,能让 AI 系统跨越不同地区可靠地抓取数据,同时将封锁降到最低。
众包与用户生成数据
AI 模型通常需要带标签的数据集,例如情感标签或图像分类。像 Amazon Mechanical Turk 或 TapResearch 这样的平台可以提供这些由人工标注的输入数据。
尽管贡献者是真人,但使用代理有助于模拟来自不同地区的访问,或对 IP 进行匿名化以实现统一的参与者招募。这确保了获得广泛且地域多样的反馈,而不仅仅局限于基于 IP 的位置画像。
传感器、IoT 与智能设备
来自 IoT 设备、GPS、传感器、摄像头的数据, 智能家居设备 对于机器人和预测性分析等特定 AI 领域至关重要。这些设备会将数据流式传输到服务器,通常横跨多个地理节点。
虽然硬件本身不需要代理,但后端服务可能会使用代理来对边缘数据源进行匿名化处理,尤其是在实地部署或区域测试的场景中。
API 与公共数据集
有时,收集数据的最佳方式并非爬取,而是使用官方渠道。
大量的 AI 数据收集来自 Reddit、Twitter 或 Common Crawl 等公共 API。在这里,代理对于避免速率限制和保持会话多样性至关重要。住宅代理允许跨多个令牌进行并行连接而不会被限流。
合成数据与 GANs
像 GANs 这样的生成式 AI 模型能够创建合成图像、文本或声音,为边缘案例或代表性不足的类别补充真实世界数据。
这里对代理的需求较少,但代理仍可为横跨多个地理节点的分布式生成基础设施提供支持。
在多区域生成中,代理可以为分布式计算或云节点交互提供支持,尽管相较于纯抓取型管道,它们在合成型管道中的核心地位要低一些。
AI 训练前的数据处理
收集原始数据只是第一步。在 AI 摄取之前,数据必须经过清洗、去重、归一化和标注。想象一下抓取数十万个网页:重复内容、无关内容和噪声都必须被过滤掉。
OCR、NLP 标注和图像过滤会对输入进行标准化。在这一阶段,代理已不再是必需,但它们在稳健的数据采集中所发挥的初始作用是根基性的。
AI 数据收集中的伦理与隐私考量
大规模收集数据会引发隐私和伦理方面的挑战。不加节制的抓取可能会侵犯版权、使服务器过载,或包含个人数据。
代理必须以负责任的方式使用,包括轮换 IP、遵守 robots.txt、尊重速率限制,并避免抓取私密或敏感数据。
符合伦理的 AI 要求对数据进行匿名化或结构化处理以移除 PII,在必要时征得同意,并采用如联邦学习这样的隐私保护训练技术。代理在分散访问、避免让任何单一域名过载方面发挥着作用。
AI 从反馈循环和用户交互中学习
推荐引擎和聊天助手等 AI 系统通常会从用户反馈中学习。无论是带标签的纠正,还是记录在会话日志中的选择,这些数据都会持续优化模型。
代理基础设施有助于对反馈的提交进行匿名化或分布式处理,尤其是在跨地域或基于设备的实验中收集数据时。
虽然代理并非反馈循环本身的核心,但它们支撑着收集数据并将其输入系统的分布式、可扩展基础设施。
AI 数据采集与质量方面的挑战
规模并不等于质量。抓取不当的数据可能会给模型引入偏差或噪声。举例来说,糟糕的 IP 卫生(例如使用了被标记的代理)会扭曲地理分布、降低样本完整性,或引入系统性误差。
高效的数据管道依赖于严格的数据验证、审计、增强和偏差校正。代理通过实现广泛的地理覆盖和多样化的 IP 来源提供帮助,但前提是它们得到妥善管理,并在健康状况和区域一致性方面受到持续监控。
支持 AI 数据采集的工具、平台与代理基础设施
各家公司依靠 NetNut、ScraperAPI、Bright Data 和 PacketStream 等工具,通过轮换的住宅代理或移动代理来管理大规模抓取。
这些平台集成了轮换逻辑、请求头伪装、RSS 和 JS 路径爬取以及 IP 健康状况追踪。
对于 AI 团队来说,这些供应商 API 能够在各类抓取管道中自动完成代理集成,实现大规模稳定的数据采集、区域多样性以及最少的中断。
结语:AI 数据采集的未来
随着 AI 的发展,数据策略也在不断演进。AI 数据采集的未来取决于:
- 采用联邦学习或边缘优先策略,让数据保留在设备本地
- 以合成数据为先的管道,可减少对网页抓取的依赖
- 用于公平模型训练的多区域代理管理
- 构建于代理基础设施之上的合规采集协议
归根结底,更出色的 AI 需要更优质的数据,而干净、合规的基于代理的数据管道,让海量数据收集得以在不损害信任或合法性的前提下实现。
NodeMaven 如何解决 AI 数据采集的基础设施难题
大多数 AI 项目遇到的瓶颈并非出在模型调优上,而是出在数据管道上。IP 封禁、速率限制和地理限制会扼杀项目势头。这正是 NodeMaven 大显身手之处。
如果你曾尝试过大规模收集训练数据,很可能已经遇到过其中一些问题:
- 你的抓取程序在 100 次请求后就被封锁了。
- 即便数据是公开的,你的 IP 仍被标记。
- 你需要抓取某个本地市场的数据,却无法从当前所在地区访问相关内容。
- 你的云托管 IP 因与数据中心关联而被封禁。
这不是抓取问题,而是代理问题。
NodeMaven 专为支持 AI 级数据操作而打造。借助 轮换住宅代理, 移动代理,以及 粘性 IP 控制,你可以运行分布式爬虫,而不必冒着被封禁或耗尽 IP 的风险。
以下是 NodeMaven 如何让你掌控数据层的方式:
- 真实 住宅代理 和 移动代理 IPs: 不共享,也不回收利用。这些都是信任度极高的真实用户 IP,非常适合隐蔽爬取。
- 区域级定位: 想用魁北克法语的 Reddit 帖子来训练 AI?还是印度尼西亚的旅游博客?借助城市级和 ASN 级的定位,你可以获得精准的覆盖范围。
- 会话粘性与轮换: 从已登录的会话中采集动态内容,或在每次请求时切换 IP。这完全取决于你的数据管道逻辑。
- 兼容你的技术栈: 无论你运行的是 Python 抓取程序、Puppeteer 机器人,还是无头浏览器集群,NodeMaven 都能通过 API 或控制面板顺畅地集成。
可以这样理解: 你的代理基础设施越出色,你的 AI 数据集就越快速、越干净,下游的工程难题也就越少。
如果你正在构建一个真正严肃的 AI 模型,就不要只靠运气。用为规模化而设计的基础设施来构建它。


