
别再抓取页面了,改为寻找 API


在费力驯服浏览器之前,先看看它已经在为您做什么。
您打开一个页面。需要的数据就在那里,明明白白地显示在屏幕上。然后您查看页面源代码,发现它几乎是空的。只有一副 div 骨架。没有价格。没有列表。没有任何可以解析的内容。
页面下方某处有一个“加载更多”按钮,或者是无限滚动,又或者是一个在页面加载后稍等片刻才填充内容的加载动画。您的第一反应是 Selenium。或者 Playwright。启动浏览器,等待元素出现,点击按钮,抓取渲染后的 DOM。
这种直觉通常是错的。
在编写任何一行浏览器自动化代码之前,先看看您的浏览器已经在做什么。它一定是从某个地方获取数据的,别无他法。那个“空白”页面之所以能填满商品,是因为 JavaScript 调用了后端,并把响应渲染成了屏幕上的像素。
找到那个请求。复制它。自己运行一遍。
整个技巧就是这么简单。它只需几分钟,却能为您省下数小时与无头浏览器、等待条件以及每次改版都会失效的选择器缠斗的时间。
我们来找找看。

您的浏览器已经在和数据源对话
现代网站大多是架在 API 之上的界面。首次加载时拿到的 HTML 往往只是一个空壳。真正的内容要等页面向后端发出请求并拿回 JSON 响应后才会出现。JavaScript 接过这个响应,再把它绘制到屏幕上。
您可以把它称作“隐藏 API”。 这是一个实用性的称呼,而不是技术上的定义。它通常并不是什么秘密。
它只是前端用来获取自身数据的内部端点,而当初没有人在构建它时会预料到爬虫会直接看到它。正因如此,它往往比 HTML 要诚实得多。
这对您为什么重要:
- HTML 是为渲染而生的,而不是为解析而生。它充斥着布局噪音、广告位,以及每次改版都会变动的标记。
- 浏览器自动化成本高昂。每个无头浏览器实例都会吞噬内存和 CPU。乘以成千上万个页面,开销很快就会累积起来。
- API 响应通常已经是结构化的。商品、价格、ID 和图片都以干净的字段形式返回,而不是深埋在三层 div 之下。
- 分页问题往往已经解决。为“加载更多”按钮提供数据的端点通常接受页码或游标参数。您不需要去点击那个按钮,只需调用按钮所调用的接口即可。
- 筛选和排序通常也只是参数而已。 分类、排序方式和搜索词通常会直接出现在请求 URL 中。
跳过渲染,直接与数据源对话。
找到请求,而不是与页面较劲
这里主要靠 Chrome DevTools 来完成。Firefox 的 Network 面板用法也一样。
- 打开目标页面。
- 打开 DevTools(按 F12,或右键选择“检查”)。
- 切换到 Network 标签页。
- 按 Fetch 或 XHR 筛选。这样可以隐藏图片、字体和 CSS,只留下真正重要的流量。
- 重新加载页面。
- 触发任何会加载您所需数据的操作。
- 观察请求逐一出现。
- 逐个点击这些请求,查看 Response 标签页。
值得触发的操作:
- 点击“加载更多”
- 滚动页面触发无限加载
- 在搜索框中输入内容
- 应用筛选条件
- 更改排序方式
- 翻页浏览结果
- 选择商品规格
您需要在响应中寻找的内容:
- 返回 JSON,而不是 HTML
- 一个条目数组(商品、房源列表、帖子,或页面展示的任何内容)
- 分页字段,例如 page、totalPages 或 hasNext
- 与屏幕上可见内容一一对应的 ID
- URL 中看起来用于控制查询的参数
您首先要在大量噪音中逐个点击筛查:分析统计请求、广告跟踪器、会话心跳。全部忽略即可。您要找的是真正为页面提供数据的那一两个请求。
如何判断您找到的是正确的端点
并非每个 200 OK 都有用。在动手构建任何东西之前,先逐项核对以下几点:
- 响应正文中包含您真正需要的记录
- 在页面上更改筛选条件、页码或搜索词时,请求也会随之变化
- 数据是结构化的,而不是一大片 HTML
- 该端点接受您可以控制的参数
- 您可以在浏览器之外发送同样的请求,并得到相同的结果
绿色的状态码只代表服务器给出了响应。然而,有些端点返回的是部分数据、空占位符,或仅供某个小部件使用的 HTML 片段。有些则返回 GraphQL 而不是普通数组。在围绕某个端点构建爬虫之前,每次都要检查实际返回的内容。
复制请求并进行测试
发现了有希望的请求?在 DevTools 中右键点击该请求,选择 Copy as cURL。
将其粘贴到:
- Postman
- Insomnia
- 一个使用 requests 库
复制下来的请求为您提供了重现它所需的一切:
- The URL
- HTTP 方法
- 查询参数
- 请求体(如果是 POST 请求)
- 请求头
- Cookie
- 浏览器携带的任何会话或身份验证状态
重要提示! 请只复现您有权访问的请求,并遵守目标网站的服务条款。
将请求粘贴到您选用的工具中,点击发送,然后检查是否得到与 DevTools 中看到的相同响应。如果一致,您就获得了一个可用、可脚本化的数据源。
找出真正起作用的参数
真正的省时之处就在这里。
查看您找到的请求的查询字符串:
值得测试的常见参数:
- 页面 或 offset:返回哪一段结果
- 限制 或 page_size:每次请求返回多少条结果
- cursor:用分页令牌代替页码
- 查询 或 q:搜索关键词
- 类别 或 筛选:缩小结果集范围
- sort:改变结果排序
现在稍微试探一下它们的极限。
如果网站前端始终只显示每页 20 条内容,不妨尝试请求 50 或 100 条。有时后端会接受这样的请求。仅这一处改动 就能减少您的总请求数,这意味着触发速率限制的几率更低,爬虫整体运行速度也更快。
如果端点暴露了游标(cursor),您可以 直接串联请求 ,而无需猜测页数。如果筛选条件只是参数,您就可以精确请求所需的那部分数据,而不必先全部拉取再在客户端筛选。
不要以为这种方法总是奏效。 服务器通常会限制页面大小。有些会忽略无法识别的参数。有些则会在您超出内部限制的那一刻直接报错。每一次参数改动都要经过测试。
从一个请求到一个真正的爬虫
一旦确认了端点及其参数,把它变成一个可用的爬虫基本上只是搭建管道的工作。
就这么简单。 只需一个循环、一次请求,以及一个可以直接解析的 JSON 响应。
添加错误处理,遵守速率限制,并按您的需要存储结果:CSV、数据库,或者任何您的数据管道所期望的位置。核心循环很少需要比这更复杂。
当这条捷径行不通时
直接调用 API 并非万能。它们也会失败,最好提前了解失败的原因。
这种捷径通常在以下情况下失效:
- 该端点 需要身份验证 ,而您无法合理地复现
- 它依赖于会话 很快就会过期的 cookie
- 令牌会动态轮换,并且 需要重新生成
- 该端点 要求浏览器生成的状态,例如指纹或签名请求
- 速率限制非常严格
- An 反机器人系统 部署在端点前面
- 该 端点经常变动,因为它本来就不是一个稳定的公开 API
- 数据确实只 在客户端 JavaScript 运行之后才存在,背后没有对应的请求
当您撞上其中任何一堵墙时,浏览器自动化就真正派上用场了。 Playwright 或 Selenium 当浏览器本身必须成为工作流的一部分,而不只是一个您试图绕开的渲染引擎时,才有意义。
代理在 API 采集中的作用
一旦您的爬虫直接请求某个端点,发送的请求量往往远超人工逐页点击所能达到的水平。这正是采用这种方式的意义所在,但也正是基于 IP 的速率限制和封锁开始产生影响的地方。
此外,代理配置取决于具体的工作流程。跨数千个请求拉取分页结果通常需要 轮换住宅代理,将流量分散到不同的 IP 上。
围绕登录或持久会话构建的工作流程则更适合使用 粘性会话 ,在一段时间内保持同一个 IP。
需要在数小时内保持单一稳定身份的长时间运行任务,通常更适合搭配 静态 ISP 代理.
NodeMaven 运营着覆盖 190 多个国家/地区、拥有 3000 万+ IP 的住宅代理池,支持轮换与粘性会话(最长 24 小时)、HTTP(S) 和 SOCKS5 协议,以及城市或 ZIP 级别的定向。
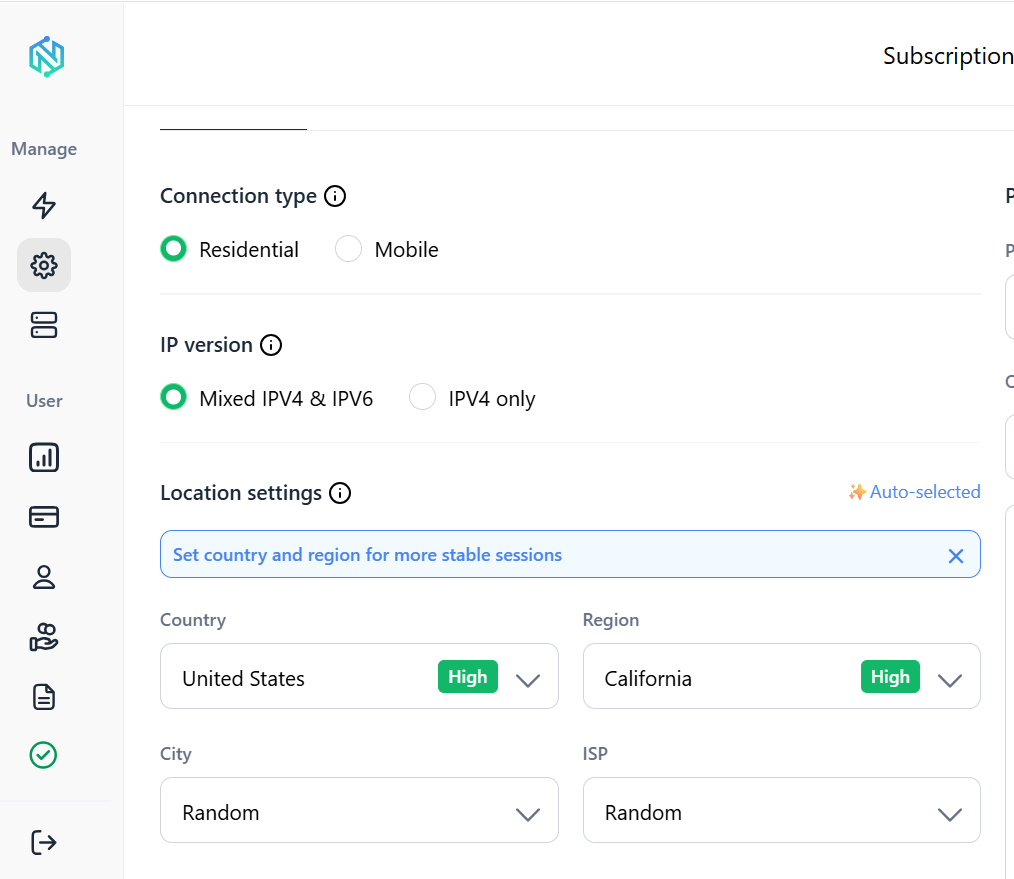
移动代理和 ISP 代理则覆盖需要不同 IP 画像的工作流程。所有这些都能与 Python 的 requests 库无缝配合,因此将代理接入上述循环只需简单修改一下配置即可。
隐藏 API 还是浏览器爬取?
| 方法 | 最适合 | 主要优势 | 主要缺点 |
| 直接 API 请求 | 前端调用 JSON 端点的网站 | 速度快、数据干净、资源开销低 | 端点可能在不另行通知的情况下变更,可能需要处理身份验证 |
| Playwright | 重度依赖 JS 的网站,以及需要真实浏览器行为的工作流程 | 可处理渲染、点击以及复杂流程 | 比原始请求更慢、更消耗资源 |
| Selenium | 成熟的自动化流水线、传统工具链 | 生态成熟,浏览器支持广泛 | 通常比 Playwright 慢,配置开销更大 |
使用能够为您提供所需数据的最简单层级。
30 秒检查清单
在启动 Selenium 或 Playwright 之前:
- 打开 Network 标签页
- 按 Fetch/XHR 筛选
- 重新加载页面
- 触发动态内容(滚动、点击、筛选、搜索)
- 检查 JSON 响应
- 找到分页或筛选参数
- 将请求复制为 cURL
- 在浏览器之外测试它
- 用循环将其自动化
- 如果工作流需要扩大规模,请添加代理
您看到的网站并不是数据真正所在的地方
您正在查看的页面很少是数据的真正来源。在它背后的某个地方,一个请求发出、一个响应返回,屏幕上的一切都是由这次交换构建出来的。
在动用浏览器之前,先找到那个请求。大多数时候,这只是五分钟的绕行,却能为您省去数小时的 Selenium 等待、脆弱的选择器和缓慢的页面渲染。
一旦您的爬虫直接与 API 对话,下一个问题就是规模。NodeMaven 为您提供住宅、移动和 ISP IP,让这些请求持续运行而不会触发速率限制。 以 $3.50 试用 ,看看一个干净、直连 API 的爬虫能带您走多远。


