
2026 年最佳网页抓取工具?DeepSeek + Crawl4AI


传统的网页抓取意味着编写选择器、修复失效的解析器,并在网站每次改版时重写代码。DeepSeek 网页抓取提供了另一种思路:先让爬虫获取原始页面,再由 AI 模型读取页面并将其转换为结构化数据。
搭配开源爬取与提取框架 Crawl4AI,这套流程在开发者中颇受欢迎,因为无需为全托管的抓取 API 付费即可实现 AI 驱动的网页抓取。它也是当前 AI 抓取技术栈。核心思路很简单:
网站 → Crawl4AI → 提取内容 → DeepSeek → 结构化数据
整条流程就是这样。Crawl4AI 访问页面并提取出干净的内容,DeepSeek 读取这些内容并返回您真正需要的字段,例如价格、标题或库存情况。
本指南将完整讲解整套配置流程:安装 Crawl4AI、将其与 DeepSeek 连接、构建一个真实的提取示例,并了解大规模运行时的成本。

DeepSeek + Crawl4AI 有何不同?
Crawl4AI 和 DeepSeek 解决的是两个不同的问题。理解这一分工,会让您更容易读懂本指南的其余部分。
Crawl4AI(爬虫层):
- 访问页面,并在需要时渲染 JavaScript
- 提取原始 HTML 并转换为干净的 Markdown
- 支持使用 CSS 或 XPath 选择器进行结构化提取
- 对大型页面进行分块,避免 AI 模型无法处理
如需对浏览器自动化和 JavaScript 密集型页面进行更多控制,您还可以比较 Playwright 与 Selenium 在网络爬虫中的表现.
DeepSeek(AI 层):
- 读取 Crawl4AI 传递过来的内容
- 解读杂乱、不一致或非结构化的文本
- 提取您指定的特定字段
- 返回 JSON 等结构化输出,而不是一大段文字
DeepSeek 并不能取代爬虫。它无法自行访问网站、点击按钮或渲染 JavaScript,这些工作要先由 Crawl4AI 完成。DeepSeek 的任务是在页面内容已经采集之后才开始的。
这一分工很重要,因为它决定了您排查问题的方式。如果数据完全缺失,通常是爬虫出了问题;如果数据存在但格式很差,那多半是 DeepSeek 一侧的提示词或提取指令有问题。
AI 驱动的网页抓取如何运作
完整的工作流程可以拆解为一个简短的步骤序列:
- 确定目标 URL
- 通过 Crawl4AI 发送请求
- Crawl4AI 采集并清洗页面内容
- 将内容转换为 Markdown
- 将相关内容发送给 DeepSeek
- DeepSeek 提取您指定的字段
- 结果以结构化数据(通常是 JSON)返回
- 将结果保存到文件或数据库
把爬取与 AI 处理分离,可以让每一部分都易于调试、运行成本更低。 只有在内容确实需要解读时,您才需要为 AI 模型付费,而不是为每一次请求付费。
示例: 假设某个产品页面包含名称、价格、库存状态、星级评分,以及一段被埋在杂乱 HTML 结构中的描述文字。Crawl4AI 会抓取整个页面并将其转换为 Markdown。随后 DeepSeek 读取该 Markdown,并按固定的 JSON 结构准确返回您所要求的那四五个字段,无论源 HTML 有多混乱。
开始前需要准备什么
所需条件很简单。您需要:
- Python 3.10 或更高版本
- Crawl4AI 软件包
- 一个 DeepSeek API 密钥
- 一个您有权抓取的目标网站
- 如果网站会拦截重复请求,还需要代理基础设施
Crawl4AI 既可以作为本地 Python 包运行,也可以通过 Docker 运行。做测试时,本地安装是更简单的起点。当您想把 Crawl4AI 作为托管服务运行时,Docker 会更有用。由于该项目更新频繁,请始终查阅最新的 Crawl4AI 文档以获取准确的安装命令。
如何配置 Crawl4AI
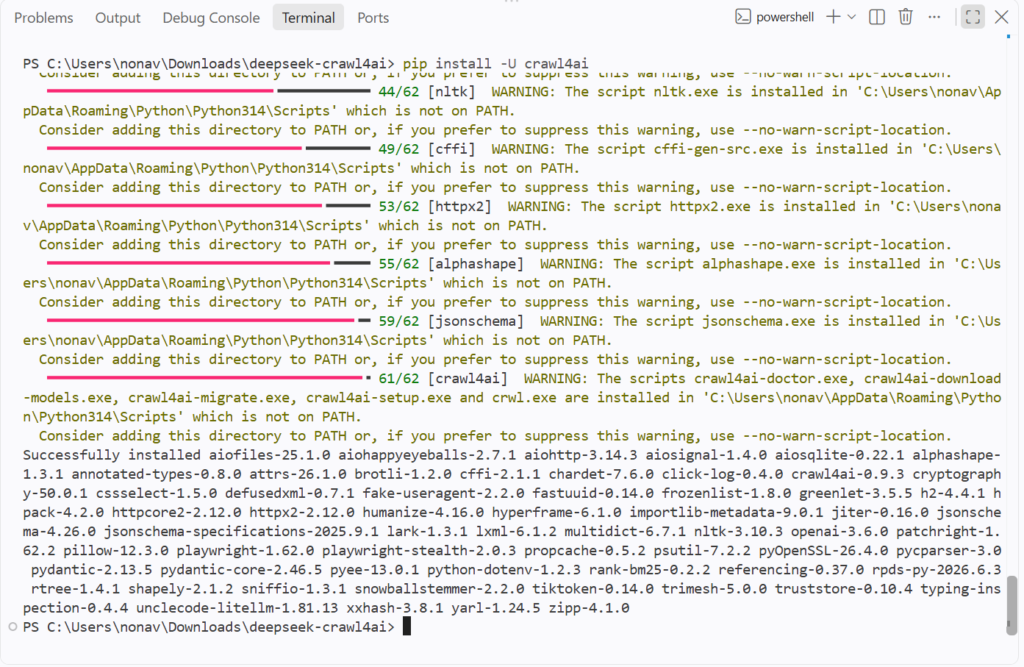
首先创建一个 Python 项目并安装 Crawl4AI:
Crawl4AI 的 setup 命令会安装浏览器组件并完成项目的初始设置。如果您更倾向于使用托管环境,而不是自行维护浏览器基础设施, 爬虫浏览器 也是另一种选择。
您可以用以下命令检查安装情况:
现在运行一次最小化的爬取,确认一切正常:
Crawl4AI 会以 Markdown 形式返回页面内容。在我们的测试中,它成功爬取了 Books to Scrape 网站,并返回了页面内容,包括其分页链接。
这种 Markdown 输出对下一步很有用,因为相比原始 HTML,它为 LLM 提供了更清晰的页面表示。Crawl4AI 也支持将 Markdown 作为 LLMExtractionStrategy 的输入格式。
将 DeepSeek 接入 Crawl4AI
DeepSeek API 已升级到 V4 系列。当前的 API 产品线包括 DeepSeek V4 Flash 和 DeepSeek V4 Pro。两者都支持 JSON 输出、100 万 token 的上下文窗口以及思考模式。当前 API 使用 deepseek-v4-flash 和 deepseek-v4-pro 作为模型 ID。
在本教程中,我们将使用 DeepSeek V4 Flash。对于从单个网页中提取结构化数据来说,它是一个务实的选择。当您需要更高级的处理能力时,可以选用 V4 Pro。
Crawl4AI 通过其 LLMConfig 对象连接模型。随后,提取策略会告诉模型需要查找哪些信息,以及如何组织结果的结构。
首先,将您的 DeepSeek API 密钥存储在环境变量中:
请勿将密钥直接写入您的 Python 代码中。
然后配置 DeepSeek 连接:
以下是各主要参数的作用:
- 提供商 指定 DeepSeek 模型。
- api_token 提供 API 密钥。
- 指令 告诉模型需要提取什么内容。
- schema 定义预期结果的结构。
- input_format 告诉 Crawl4AI 向模型发送 Markdown 内容。
对于结构化提取,Crawl4AI 建议配合使用 schema 与 LLMExtractionStrategy。随后将该策略传递给 CrawlerRunConfig,它负责控制单次抓取。
以上代码仅配置了提取策略,尚未真正抓取页面。我们将在下一步把它与 AsyncWebCrawler 连接起来。
添加轮换代理,让抓取更稳定
基础爬虫在小规模测试中可以运行得很好。但更大规模的抓取任务会带来另一个挑战:目标网站可能会限制来自同一 IP 的重复请求。
常见原因包括:
- 高请求量
- 基于 IP 的速率限制
- 地域限制
- 反机器人系统
- 来自同一连接的重复请求
A 轮换代理 会更换请求所使用的 IP。当您的抓取程序发送大量彼此独立的请求,且无需在整个流程中保持同一 IP 时,这非常有用。
NodeMaven 支持轮换和粘性住宅代理会话,并可按国家、城市和 ISP 定位。
如需更深入地了解各类会话的适用场景,请参阅 NodeMaven 代理轮换指南.
用 Crawl4AI 抓取网站
现在,我们可以将爬虫与 DeepSeek 提取策略结合起来。
在本示例中,我们将使用 Books to Scrape 的一个产品页面,该网站专为抓取练习而设计。
创建一个 CrawlerRunConfig 并附加我们在上文配置的提取策略:
这样就把 DeepSeek 的提取逻辑连接到了 Crawl4AI 请求上。
Crawl4AI 会先获取页面并生成 Markdown 内容,随后提取策略会把相关内容发送给 DeepSeek。
DeepSeek 接收到指令和数据结构后,会尝试以结构化数据的形式返回所需字段。
例如:
具体输出取决于页面本身及其上可获取的信息。
如果您通过 NodeMaven 代理运行同样的流程,可以使用 IP 查询 工具来查看出口 IP 及其所在位置。该工具可显示 IP 的位置、ISP、ASN 和使用类型等信息。
对于规模更大的任务,您可以把同样的抓取逻辑放入循环中处理一批 URL,而不必为每个页面单独写一个脚本。
将抓取数据导出为 JSON、CSV 或 Markdown
选择哪种导出格式,取决于您流程的下一步要做什么。
| 格式 | 最适合 |
| Markdown | 将内容反馈给下一个 AI 环节或人工审核 |
| JSON | API、自动化工具与结构化存储 |
| CSV | 在 Excel 或 Google Sheets 等工具中做表格与批量分析 |
Crawl4AI 输出的 Markdown 通常是发送给 DeepSeek 的内容,而 DeepSeek 输出的 JSON 通常用于保存或转发给其他系统。如果您的最终目标是表格文件, 用 pandas 之类的库把 JSON 转成 CSV 通常只需要一行代码 pandas.
DeepSeek 网页抓取的成本是多少?
成本分为几个部分:DeepSeek API 费用、按需使用的代理费用,以及运行脚本所需的基础设施开销。
DeepSeek 的官方定价在非高峰时段(即周一至周五 01:00 至 04:00 以及 06:00 至 10:00 UTC 之外的所有时段)如下所示:
| 模型 | 输入(未命中缓存) | 输入(命中缓存) | 输出 |
| DeepSeek-V4-Flash | $0.22 / 100 万 tokens | $0.007 / 100 万 tokens | $0.66 / 100 万 tokens |
| DeepSeek-V4-Pro | $0.66 / 100 万 tokens | $0.022 / 100 万 tokens | $1.98 / 100 万 tokens |
高峰时段费率为 非高峰费率的两倍。DeepSeek 方面的价格调整往往不会提前告知,因此 请查看官方定价页面 再为大规模任务做预算。
Token 消耗会迅速累积。设想抓取 10,000 个产品页面,每个清洗后的 Markdown 页面平均约 2,000 个输入 token,外加一段简短的 JSON 响应。整个任务下来大约需要 2,000 万个输入 token 才能完成整个任务。
按 V4 Flash 非高峰时段的缓存未命中价格计算,输入部分的费用为 约 $4.40,这还未计入输出 token,也未计入提示词缓存带来的节省。
您可以通过两种方式降低成本。
第一,发送更少的内容。 Crawl4AI 在将 HTML 转换为 Markdown 时会移除大量导航和其他页面杂项。进一步精简不必要的内容,可以减少发送给 DeepSeek 的 token 数量。
第二,善用提示词缓存。 如果您的提取指令在多次请求中保持不变,输入中重复的部分就可能享受低得多的缓存命中价格。
DeepSeek + Crawl4AI 是 2026 年最好的网页抓取工具吗?
回到标题中的问题。
这一组合之所以值得关注,原因很具体:Crawl4AI 是开源的,因此您不会被某个托管平台的定价或速率限制所绑定。DeepSeek 能够理解并结构化内容,您无需为每个网站编写自定义解析逻辑。再加上代理,这套方案就能扩展到真实的流量规模,而无需依赖完全托管的抓取服务。
实话实说: 这是一个很有竞争力的低成本方案。关键是让工具与任务相匹配。


